
some1
-
Postów
1 089 -
Dołączył
-
Ostatnia wizyta
Osiągnięcia some1

ITH Sigma (5/5)
749
Reputacja
-
Wydany. https://www.flightsimulator.com/world-update-23/
-
@Wu70 ale porównanie było do 5 latka. Cyt: A jak najlepiej finansować zakup nowego samochodu, to inny temat.
-
Aaaa, no w końcu każdy właściciel nowego samochodu z małym przebiegiem sprzedaje go po 2 latach biorąc na siebie największą utratę wartości
-
Nie kryminał, tylko chińskie joint venture, więc i chińskie podejście do kokpitu. Pod znaczkiem Mazdy to Deepal. Fajnie, a co zostaje po 24 miesiącach, poza tym że wydałeś ~60k?
-
Nie ma jednoznacznej interpretacji tych przepisów, sądy też różnie orzekają w zależności od sytuacji (i sędziego). Możecie się o to spierać przez następne 20 stron.
-

Sztuczna inteligencja AI - (OpenAI, ChatGPT, Midjourney, DALL-E) - Temat ogólny
some1 odpowiedział(a) na LeBomB temat w Dyskusje na tematy różne
Obawy jak najbardziej są. Nawet w przypadku rozwiązania problemu Navier-Stokes, OpenAI nie mogło wykluczyć, że ich model wytrenował się na danych przesłanych przez innych matematyków pracujących nad problemem i wysyłających prompty do OpenAI. "While unlikely, we cannot rule out that de-identified data derived from [Buckmaster and Alpöge’s] usage of our products helped improve our models.” To jest oficjalne stanowisko OpenAI. AI też bezproblemowo sięga po kod z publicznych repozytoriów na licencjach wirusowych typu GPL czy też innych licencjach ograniczających użytek. Różnice w kodzie będą, losowość jest fundamentem LLM, bez tego nie działa. Już nie mówiąc o tym, że jeśli korzystasz z modeli AI hostowanych w chmurze, to tydzień później możesz nie gadać z tym samym modelem, oni ciągle coś zmieniają. Z drugiej strony jeśli człowiekowi dasz to samo zadanie do wykonania za tydzień to też rezultat nie będzie identyczny. -
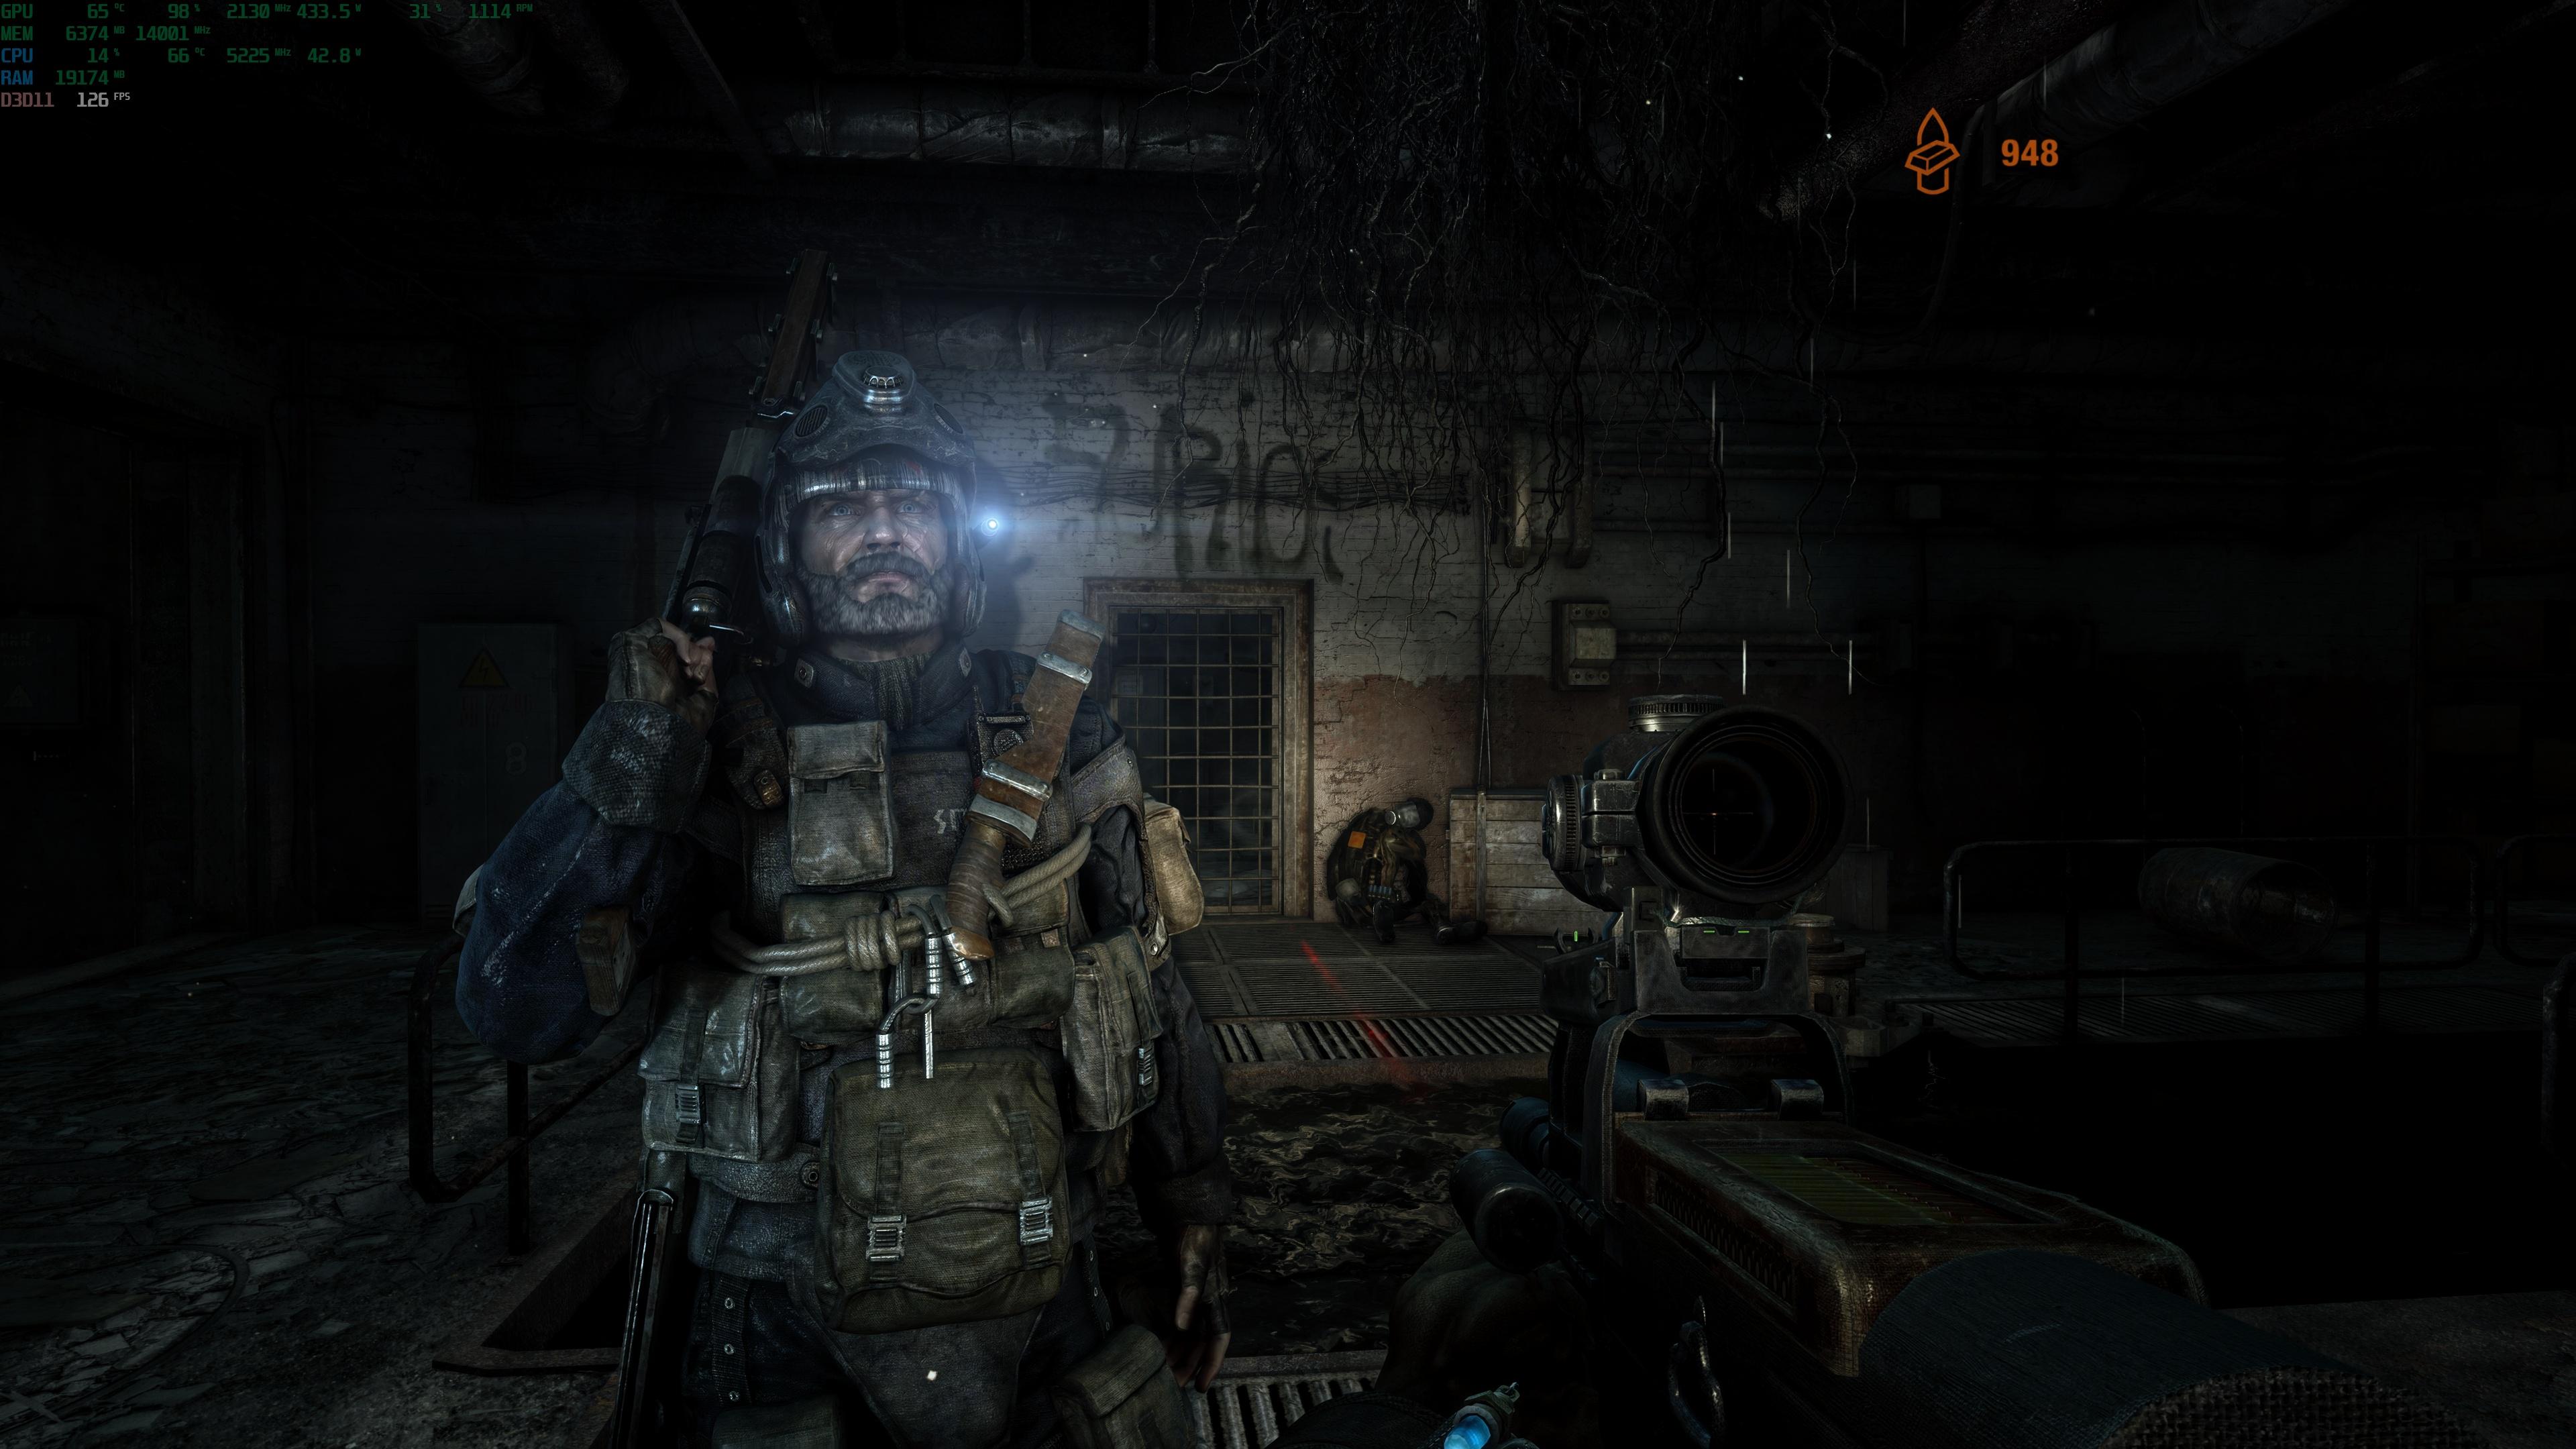
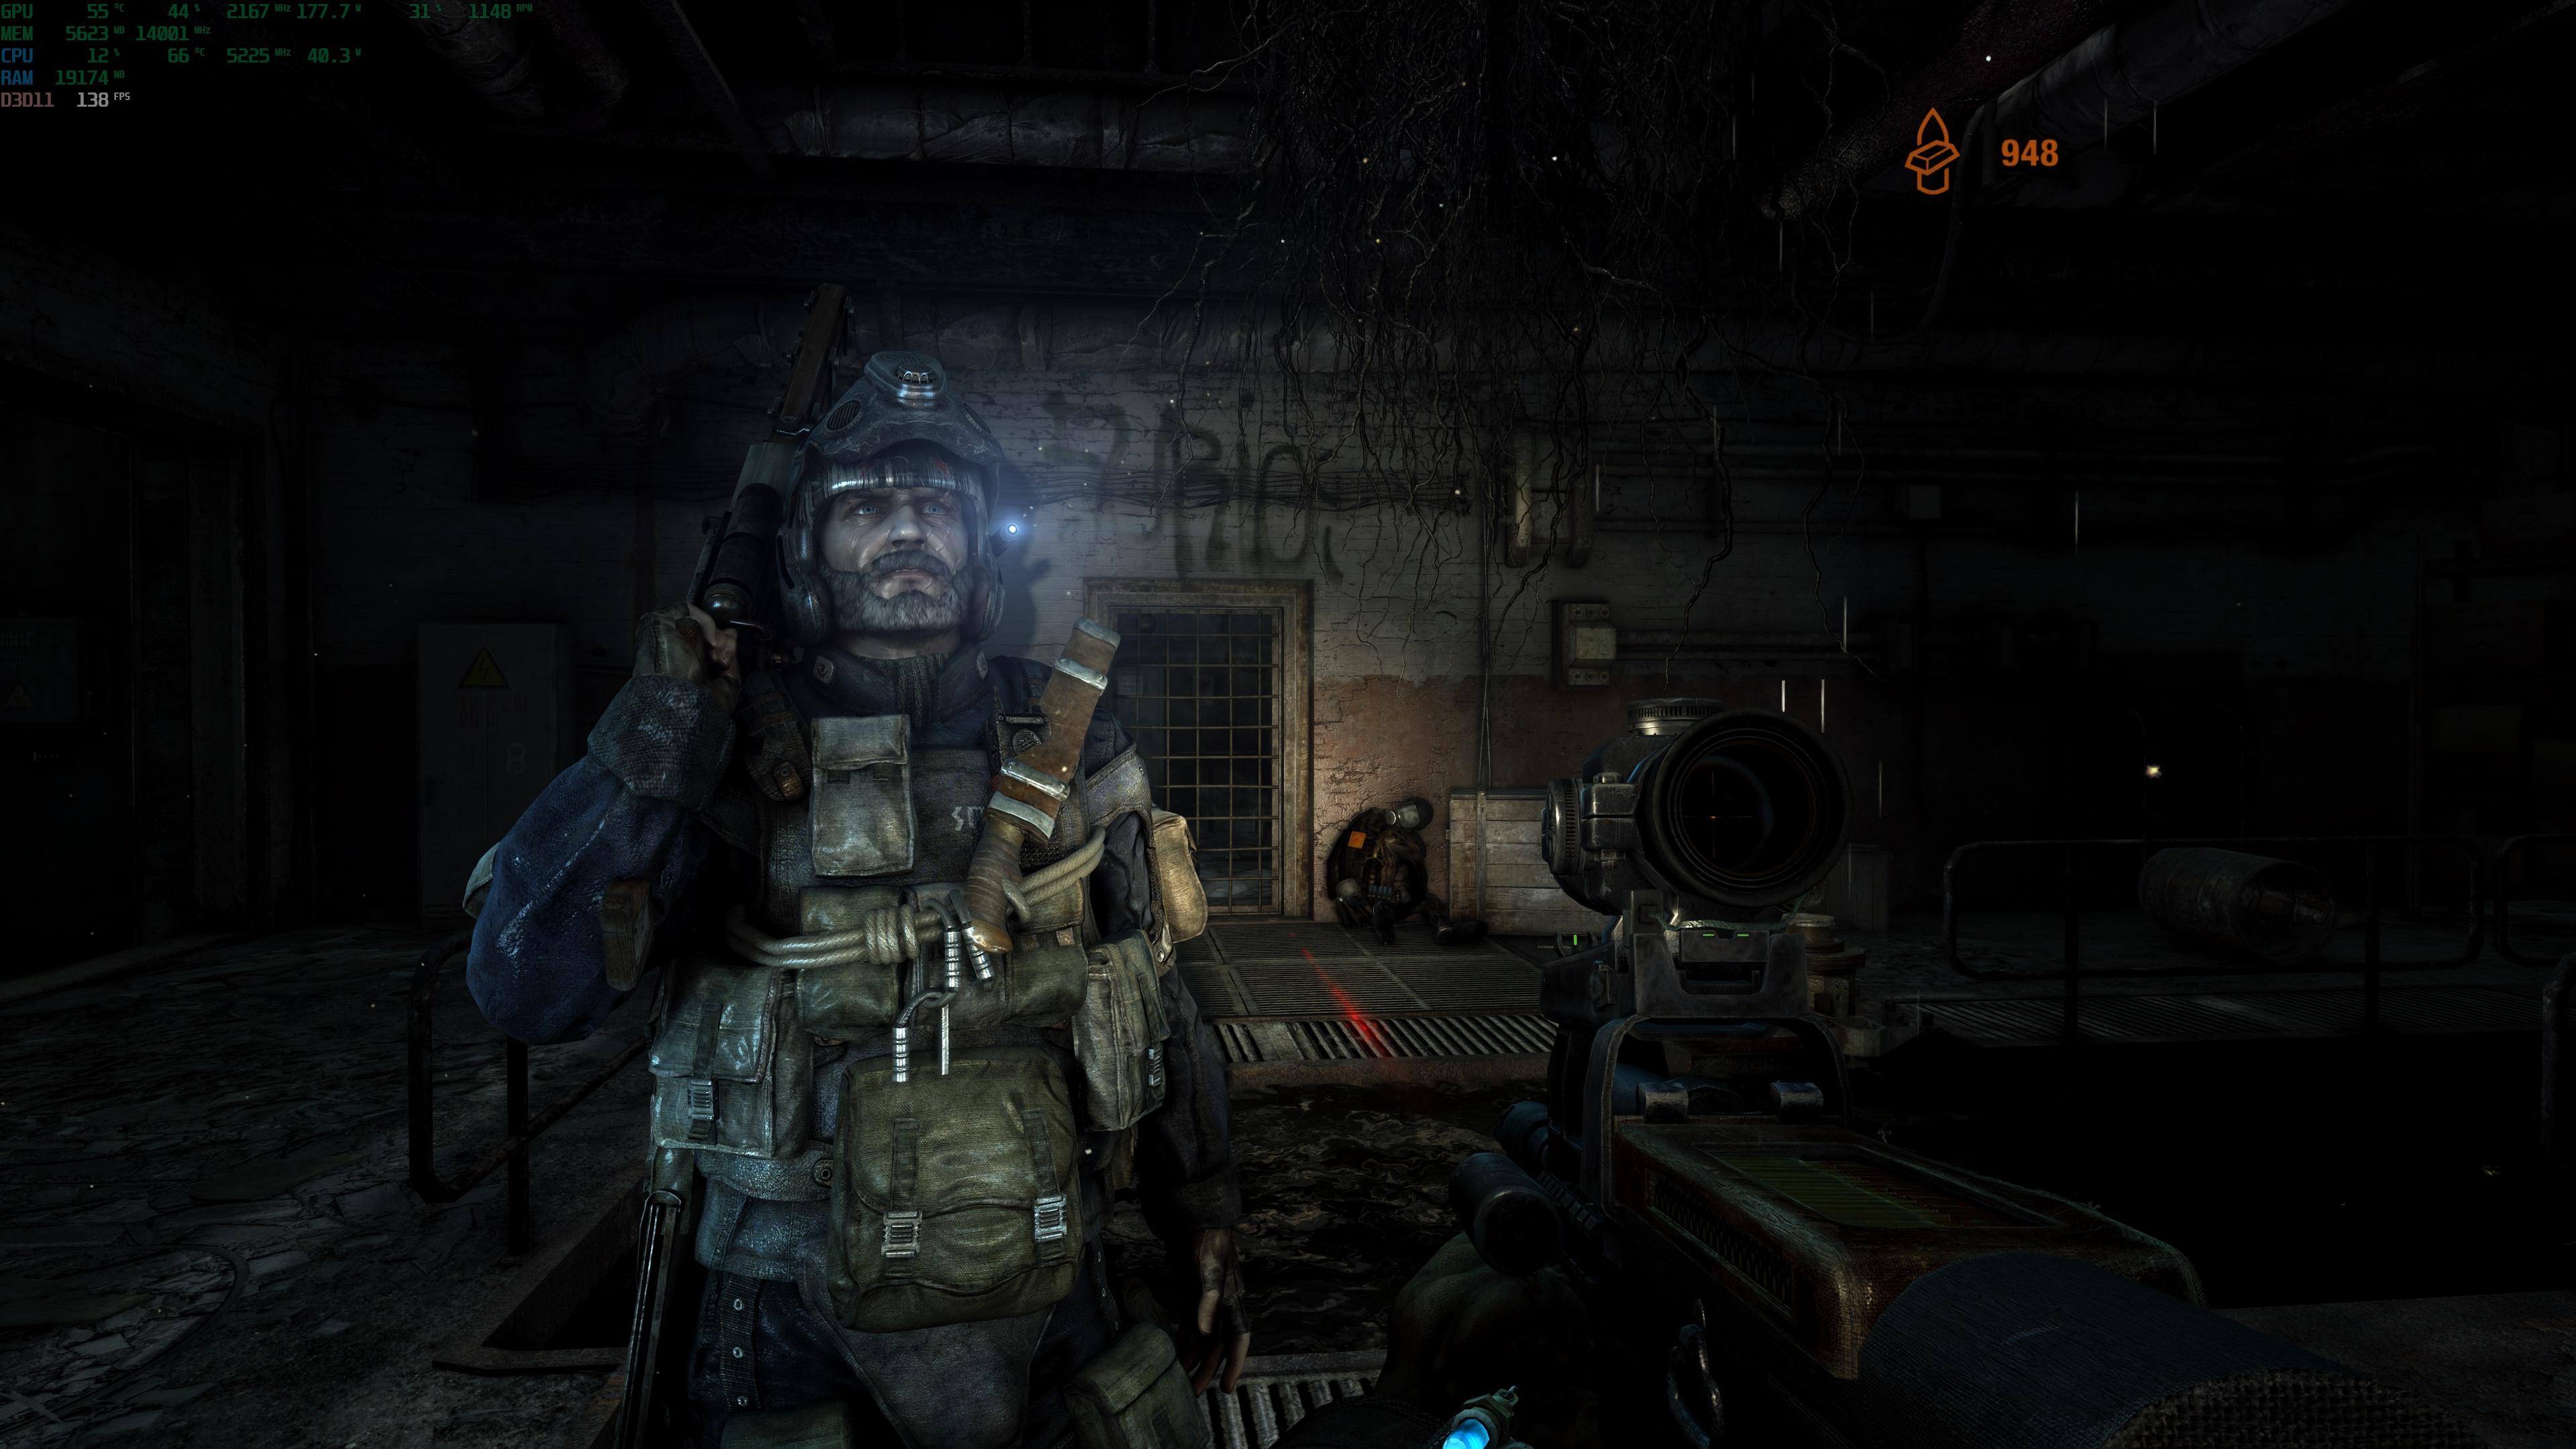
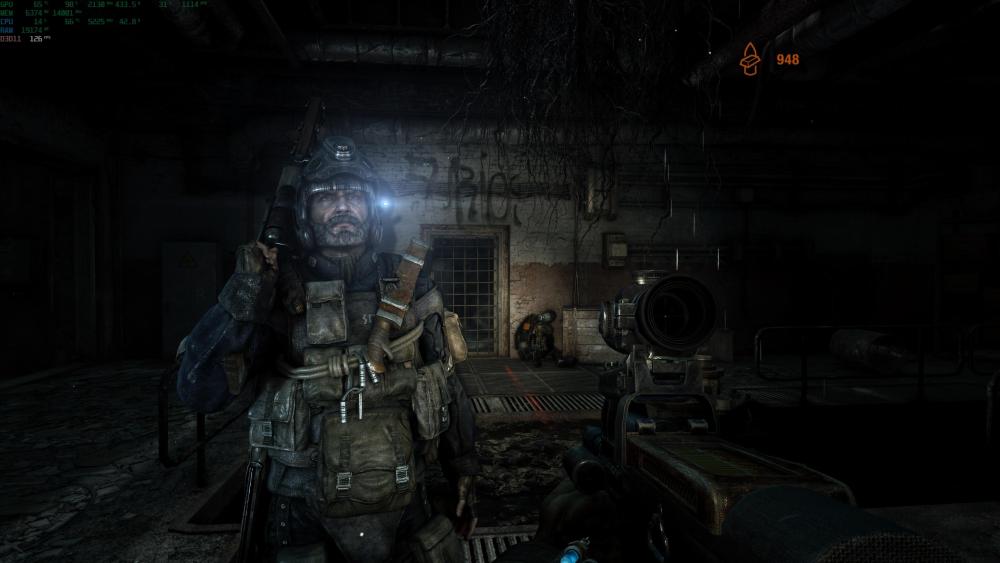
Na 5090 w 4k DLSSQ jest nawet grywalne, ponad 120 FPS. Pobór mocy po włączeniu NR skacze o 250W i to na karcie po mocnym UV. Więcej niż sama gra. Wizualnie różnica subtelna.
-
Używam, choć głównie nie do ratowania FPS'ów, a do podkręcania TLOD powyżej tego, co symulator pozwala. Dużo opcji, łatwo się pogubić.
-
Zen 6 już za kilka miesięcy, może tyle wytrzyma
-
TYLKO Auta elektryczne (BEV) - dyskusje użytkowników i opinie zainteresowanych
some1 odpowiedział(a) na SuLac0 temat w Motoryzacja
Aktualnie coraz głośniejsze są plotki, że SpaceX przejmie Teslę i akcje TSLA zamienią się w SPCX. -
TYLKO Auta elektryczne (BEV) - dyskusje użytkowników i opinie zainteresowanych
some1 odpowiedział(a) na SuLac0 temat w Motoryzacja
A giełda swoje: -
TYLKO Auta elektryczne (BEV) - dyskusje użytkowników i opinie zainteresowanych
some1 odpowiedział(a) na SuLac0 temat w Motoryzacja
Ale do tego właśnie najem się sprowadza. Musisz pokryć co najmniej utratę wartości samochodu w okresie umowy. Potem od nowa i tak w kółko. Jeśli kogoś stać i ma w planach wymieniać samochód co trzy lata, to proszę bardzo, najem jest wygodny. Nie trzeba bujać się ze sprzedażą, nie zamraża się gotówki. Większości Polaków na to nie stać. Średnio trzymamy jeden samochód przez ~6 lat. Średnio. -
Rzeźbią w tym co jest obecnie dostępne. Samsung XR, Pimax Dream AIR korzystają z takich samych. Nie ma za bardzo alternatyw.
-
Plotki, że valve pracuje nad wersją OLED, ale to odległa przyszłość. https://steamframehub.com/exclusive-here-we-go-again-valve-is-making-an-oled-steam-frame/
-
TYLKO Auta elektryczne (BEV) - dyskusje użytkowników i opinie zainteresowanych
some1 odpowiedział(a) na SuLac0 temat w Motoryzacja
Co by było gdybyś jechał BEV i była przed Tobą chociaż jedna osoba w kolejce do ładowarki? Czy zakładasz, że nigdy przenigdy się to nie wydarzy i zawsze będzie wolna stacja? Meanwhile in China: https://www.aninews.in/news/world/asia/china8217s-ev-charging-crisis-exposes-infrastructure-gap20261012183318/ Jak to dobrze, że w Polsce nie ma takich świąt, gdzie wszyscy ruszają w podróż tego samego dnia... Oh, wait