
AMDK11
-
Postów
273 -
Dołączył
-
Ostatnia wizyta
Treść opublikowana przez AMDK11
-
W obecnym podziale segmentów R5, R7, R9 zwiększą ilość rdzeni. Chyba że dodadzą segmenty.
-
Ciekawi mnie, jak wygląda powierzchnia z polami kntaktowymi mojego R7 9850X3D. Sprawdzę to, gdy będę go wymieniać na Olympic Ridge. Jak dotąd – żadnych problemów (odpukać).
-
Olympic(szczyt/góra) Ridge!!! EDIT: https://www.techpowerup.com/354964/amd-ces-2027-invite-hints-at-possible-ryzen-zen-6-olympic-ridge-reveal
-
Czyli w styczniu żadnej prezentacji Olympic Ridge?
-
Rdzeń Zen5 ST: Pobieranie z L2 1MB 42Bajty/cykl Pobieranie z L1 32KB 32Bajty/cykl Dekodowanie 4-Wide/cykl Op Cache 6K 2x6-Wide(często do 6 op)/cykl SMT: Pobieranie z L2 1MB 42Bajty/cykl Pobieranie z L1 32kB 2x32Bajty/cykl (statyczny przydział) Dekodowanie 2x4-Wide/cykl (statyczny przydział) Op Cache 6K 2x6-Wide/cykl (statyczny przydział) Rdzeń Zen6 ST: Pobieranie z L2 1MB 64Bajty/cykl Pobieranie z L1 32KB 2x32Bajty(64Bajty)/cykl Dekodowanie 2x4-Wide(8-Wide)/cykl Op Cache 6.75K 2x9-Wide(18-Wide)/cykl SMT: Pobieranie z L2 1MB 64Bajty/cykl Pobieranie z L1 32KB 2x32Bajty(64Bajty)/cykl (dynamiczny przydział) Dekodowanie 2x4-Wide(8-Wide)/cykl (dynamiczny przydział) Op Cache 6.75K 2x9-Wide(18-Wide)/cykl (dynamiczny przydział) Już to wkleiłem wcześniej ale na Chips and Cheese zrobili testy i pomiary to udowadniają: Zen5 przy pobieraniu instrukcji z L1-I dla ST nawet 30Bajtów/cykl nie pobiera a Zen6 pobiera 2x32Bajty(64Bajty)/cykl czyli oba klastry pobierania i dekodowania dostępne są dla pojedynczego wątku Także Panowie w Zen6 mamy do czynienia z totalnie przebudowanym Front-end Zen5 i nowym rdzeniem x86-64 z znacznie bardziej skomplikowaną i złożoną logiką sterującą niż w Zen5 czego nikt się nie spodziewał PS Na forum Anandtech znawcy tywierdzili że w Zen6 nie scalą dekoderów dla ST ani oba klastry nie będą dostępne dla ST bo to zbyt skomplikowane(koszt złożoności i liczby tranzystorów w logice rdzenia). AI podpowiadało że to jedyny sposób na usunięcie wąskich gardeł Front-End Zen5 Edit:
-
W AMD stwierdzono że trzecia jednostka mnożenia nie uzasadniała złożoności więc w Zen6 zostały tylko dwie (widocznie zyski z 3 jednostek mnożenia były znacznie mniejsze w ogólnym kodzie a zapotrzebowanie na tranzystory było znaczące). Poza tym w części sytałoprzecinkowej rozdzielono od ALU jednostki Branch do osobnych potoków wykonawczych więc zamiast 6ALU jest teraz 6ALU + 2Branch + 4AGU. Względem Zen5 gdzie Scheduler był zunifikowany dla 6 ALU i osobny dla 4AGU w Zen6 jest 6 schedulerów do których podpiędte są po 2 potoki wykonawcze a AGU jest zawsze z ALU. Rdzeń Zen5 Rdzeń Zen6 Rdzeń Zen6c
-
Cały czas mam na myśli sam rdzeń x86. Jeśli są nowości i zmiany w rdzeniu to już nie jest to ten sam rdzeń a nowy. Zen6 poza usprawnieniami ma totalnie przebudowane i nowe bloki i jest nowym rdzeniem względem Zen5 do tego dochodzi 50% większy L3 i zupełnie nowy IOD. Zen6 bazuje na Zen5 bo punktem wyjściowym projektu Zen6 była ogólna potokowość Zen5.
-
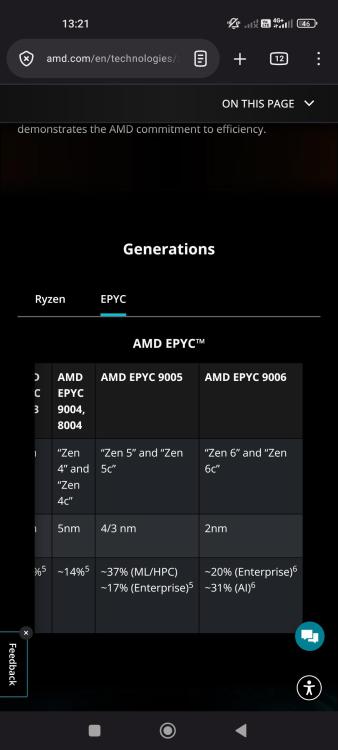
Nie zgodzę się z tym. Zen6 to nowy rdzeń i nie jest to tylko usprawnienie a m.in totalna przebudowa silnika wykonawczego oraz zwiększenie ilości jednostek wykonawczych Integer z 10 do 12 co daje łącznie 18 jednostek wykonawczych. Fron-End także został przebudowany i teraz wróciła obsługa NOP. Zen6 to także logika sterująca zdolna do łączenia obu klastrów dekodowania dla pojedynczego wątku. Zmian i ulepszeń jest naprawdę sporo mimo że bazą dla Zen6 były potężne zasoby Zen5 o czym główny inżynier AMD kilkukrotnie mówił.
-
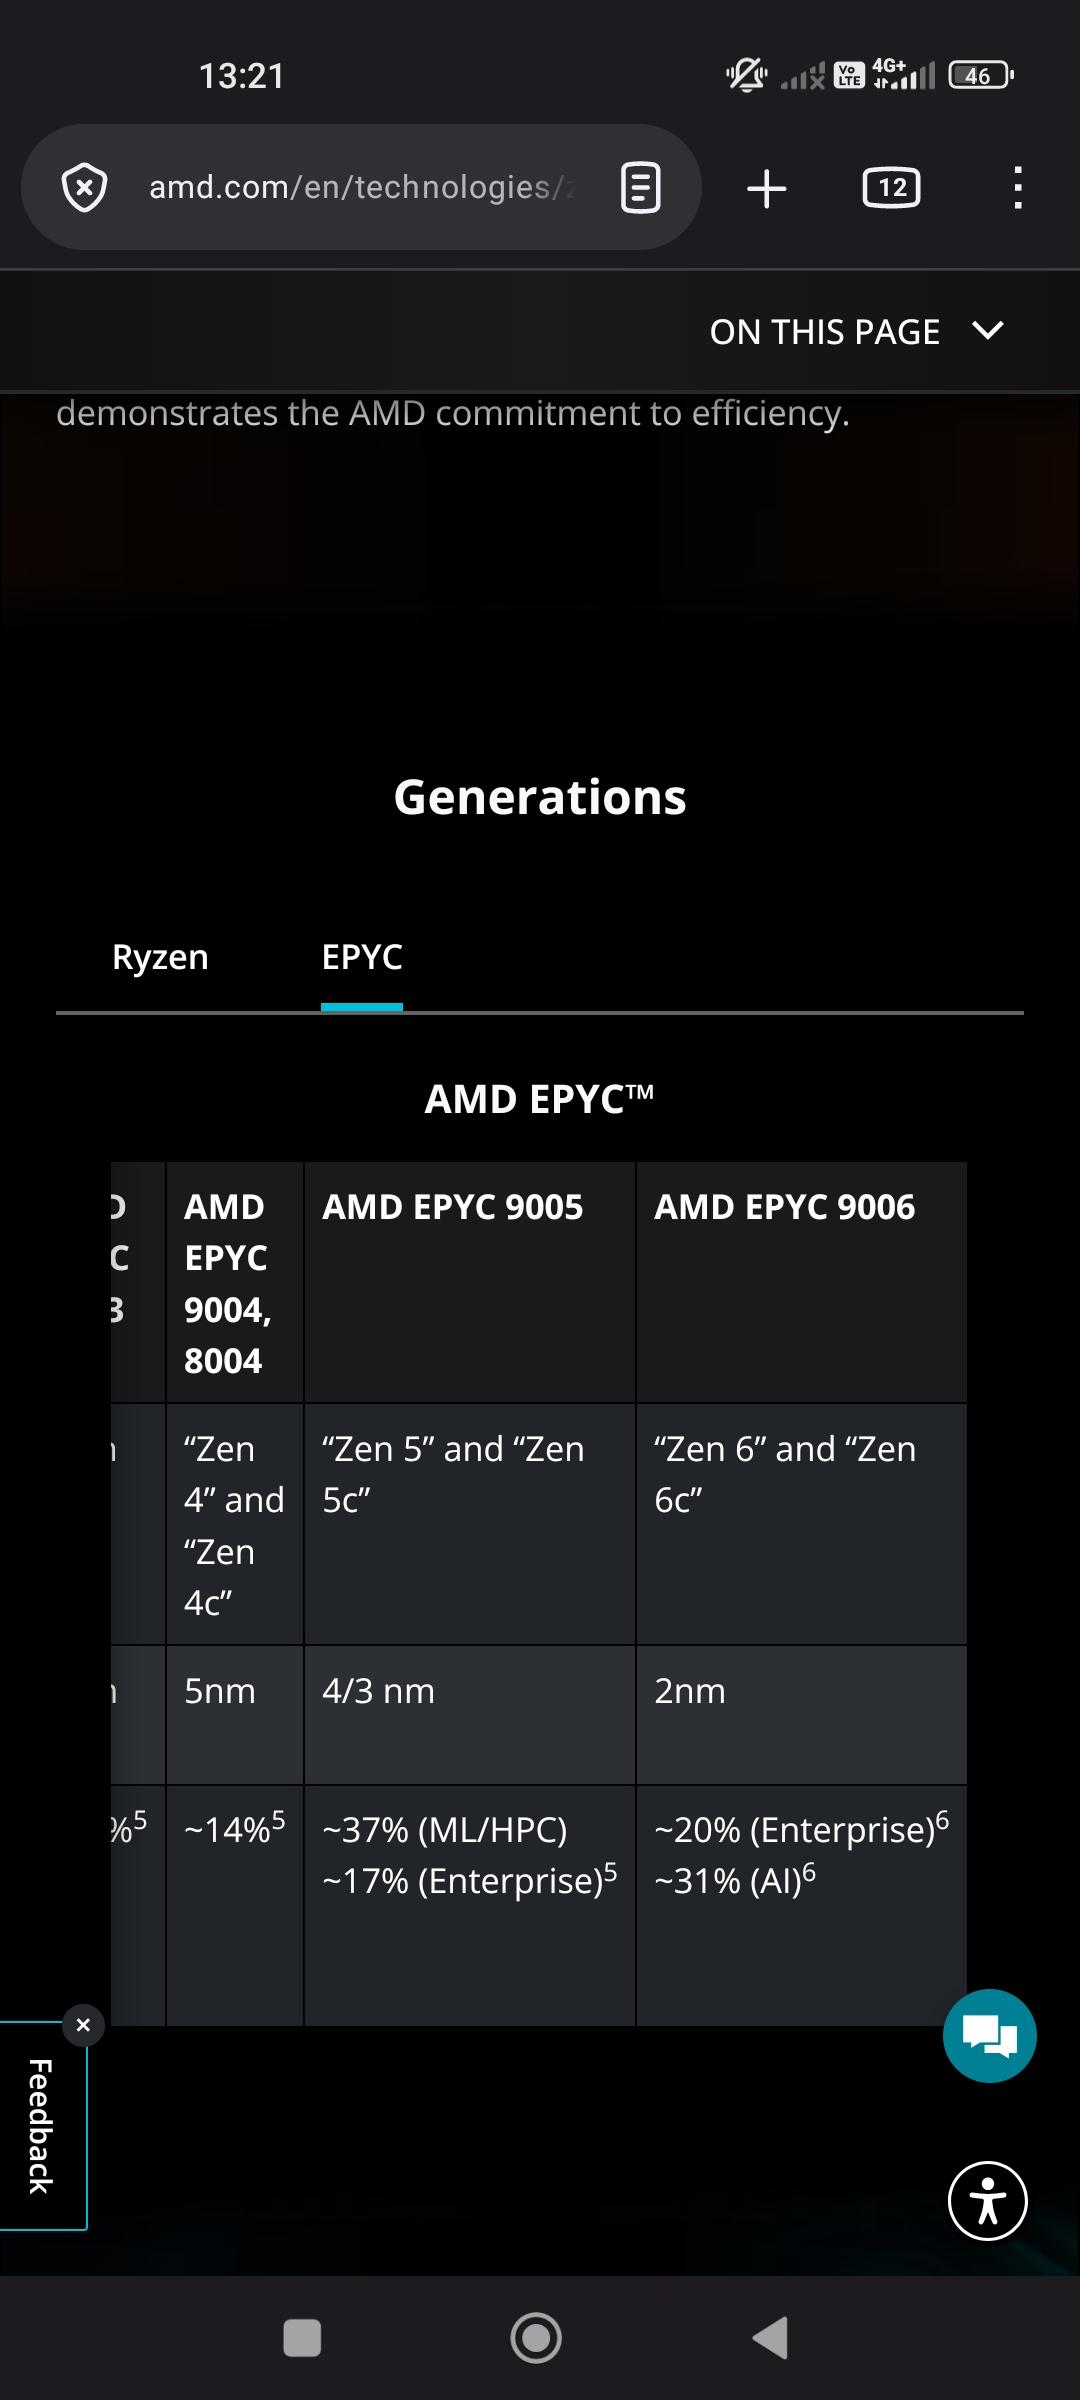
https://www.amd.com/en/technologies/zen-core.html#tabs-50df72e193-item-9cde252ee9-tab
-
Potwierdzone: Zen6 ma 2x4-Wide dekoder działający dla ST jako 8-Wide czego Zen5 nie potrafi https://chipsandcheese.com/p/amds-zen-6-family-feeding-the-beast
-
Pytanie czy taktowanie było takie faktycznie. Nie jeden soft pokazuje jedno a rzeczywistość swoje.
-
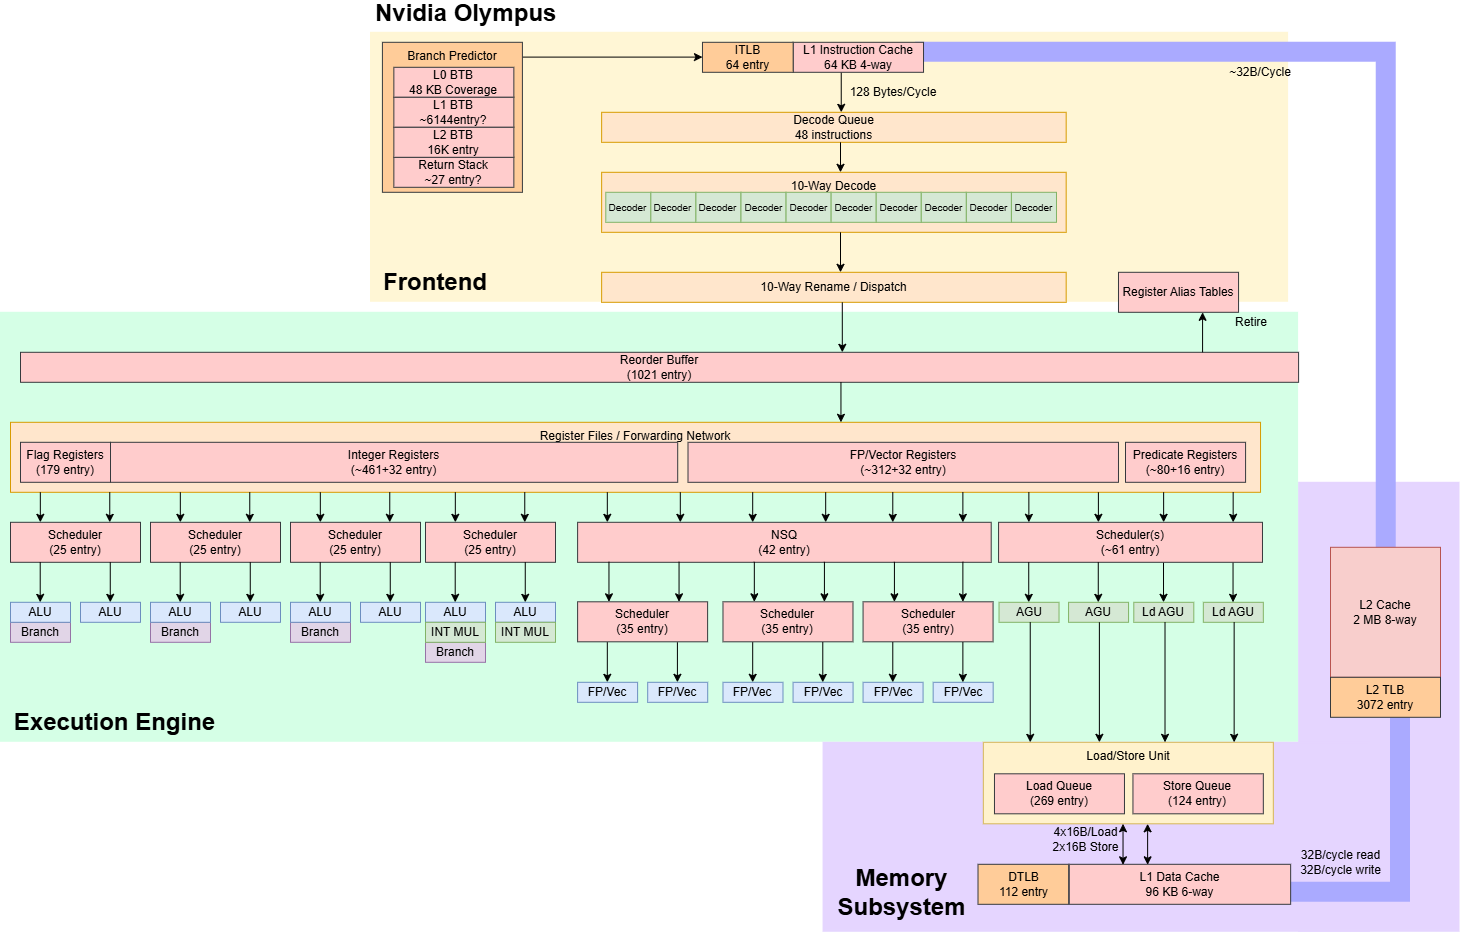
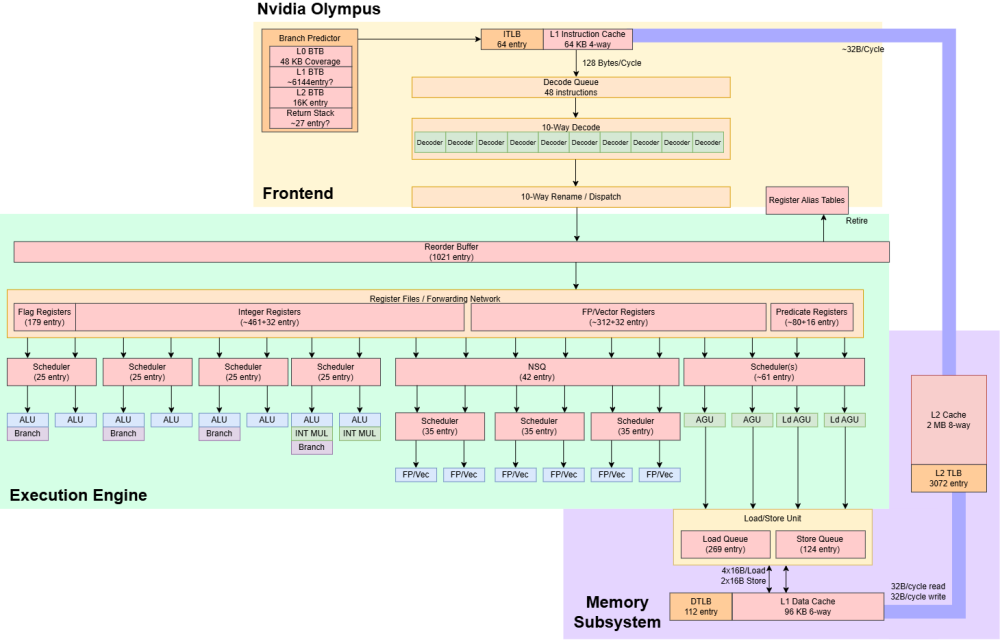
NVIDIA’s Olympus Core: Pushing Server Single Threaded Performance Boundaries https://chipsandcheese.com/p/nvidias-olympus-core-pushing-server Edit: Vs Zen5 i LionCove Edit: I niech ktoś mi powie że x86-64 w wykonaniu Zen5 jest słabe względęm potężnego rdzenia ARM Zen5 nie rzadko potrafi być szybszy i często porównywalny od rdzenia NVidii z dekoderem 10-Wide, ROB 1000+, 8ALU itd. Co ciekawe w rzeczywistych zastosowaniach najczęściej 6ALU Zen5 i 8ALU Olympus NVidii ponad 50% tych potoków jest bezczynna. Np w testach SpecINT te 8ALU jest lepsze o parę % od 6ALU Zen5 SMT działa znacznie lepiej na Zen5 Predyktor Olympus jest mniej dokładny niż ten w Zen5 ale odrobinę bardziej niż w LionCove. Predyktor Zen5 i Olympus mają podobne możliwości i przewidują 2 rozgałęzienia na cykl. Zen 5 posiada front-end, który potrafi wyeliminować aż 5 zależnych instrukcji MOV na cykl dla jednego rdzenia. NVIDIA Olympus radzi sobie z tym znacznie gorzej, eliminując zaledwie nieco ponad 1 instrukcję MOV na cykl w trybie jednowątkowym. W aplikacjach z dużą ilością kodu sekwencyjnego tworzy to mikroskopijne, ale kumulujące się opóźnienia. Cache L3(LLC 32MB i X3D 96MB) Zen5 to arcydzieło Poniżej diagram okrojonego(FPU i mniejszy L3)rdzenia Zen5 z StrixPoint ale wstawiłem bo ogólnikowo się zgadza:
-
Nie patrzę tylko na to by przeście między generacjami było 40-60%. Ja myszę mieć najnowszą i aktualną generację PS Zwłaszcza że generacja jest na rynku około 2 lat do czasu następnej.
-
Wiem. Ja ostatni raz bawiłem się w OC na platformie x99 lata temu.
-
Ja mam prościej. Wszystko ustawiam na Defult i nie jara mnie 5% więcej kosztem problemów itd.
-
Testy beta CPU-Z były wprowadzone w lutym 2021 a AVX-512 w 2022 i do tej pory nie było żadych poprawek.
-
E7 9850X3D 4.7GHz - 5.6GHz i DDR5 2x16GB 5600MT Baza CPU-Z pokazuje wynik ST 865p dla 270K Plus. Mój osiąga 833.5p czyli w tym przypadku 270K Plus jest szybszy o 3.78%. W AVX2 ST Zen5 przy 5.6GHz uzyskuje 1009.3p ale już na tym samym rdzeniu z SMT 1486p czyli +47%. Jest to mały fragment zapętlonego kodu który w kółko jest wykonywany bo realnie LionCove nie ma takiej przewagi w ST.
-
Co za idio-ta ze sprzedawcy(jak niby prawidłowo zamontować chłodzenie bez uszczerbku na optymalnym odprowadzaniu ciepła?). Zerwiesz plombę to i gwarancja przepada bo wątpię by ktokolwiek instalując ten procesor nie zerwał plomby. Edit: I tak dobrze że nie nakleił w miejscu pól kontaktowych od spodu PCB procesora W sumie dobry patent na zachęcenie klienta gwarancją
-
GCC Patch Adjusting AMD Zen 5 Misprediction Cost Nets 12% Win In Benchmark https://www.phoronix.com/news/AMD-Zen-5-Mispredict-Cost
-
GCC Patch Adjusting AMD Zen 5 Misprediction Cost Nets 12% Win In Benchmark https://www.phoronix.com/news/AMD-Zen-5-Mispredict-Cost
-
AMD Ryzen 7 9850X3D 4.7GHz - 5.6GHz CPU-Z 2.21.0.x64 Benchmark Version 19.01.64 (beta) CPU Single Thread 261.0p CPU Multi Thread 2835.1p Benchmark Version 19.01.64 AVX2 (beta) CPU Single Thread 1000.8p CPU Multi Thread 10215.5p Benchmark Version 19.01.64 AVX-512 (beta) CPU Single Thread 1168.5p CPU Multi Thread 11770.5p
-
AMD Ryzen 7 9850X3D 4.7GHz - 5.6GHz CPU-Z 2.21.0.x64 Benchmark Version 19.01.64 (beta) CPU Single Thread 261.0p CPU Multi Thread 2835.1p Benchmark Version 19.01.64 AVX2 (beta) CPU Single Thread 1000.8p CPU Multi Thread 10215.5p Benchmark Version 19.01.64 AVX-512 (beta) CPU Single Thread 1168.5p CPU Multi Thread 11770.5p Ciekawe jak u innych na ArrowLake
-
AMD Ryzen 7 9850X3D 4.7GHz - 5.6GHz CPU-Z 2.21.0.x64 Benchmark Version 19.01.64 (beta) CPU Single Thread 261.0p CPU Multi Thread 2835.1p Benchmark Version 19.01.64 AVX2 (beta) CPU Single Thread 1000.8p CPU Multi Thread 10215.5p Benchmark Version 19.01.64 AVX-512 (beta) CPU Single Thread 1168.5p CPU Multi Thread 11770.5p Ciekawe jak u innych
-
Trudno się temu dziwić. Biorąc pod uwagę obecną kryzysową sytuację na rynku pamięci RAM – gdzie pierwsze moduły DDR6 będą w rzeczywistości wolniejsze od najszybszych kości DDR5 – nie ma silnej presji na zmianę podstawki. Do tego dochodzi fakt, że różnica w wydajności kart graficznych między standardami PCIe 4.0 a 5.0 wynosi zaledwie kilka procent, więc motywacja do modernizacji pozostaje niewielka. PCIe 6.0 mogłoby wprawdzie przyspieszyć działanie dysków NVMe, ale kryzysowa sytuacja w tym segmencie również stoi w miejscu, zatem nie ma tu żadnej pilnej potrzeby zmian. To nie te czasy gdy wprowadzano nowe standardy nawet jeśli w pierwszym żucie nie było widać korzyści. Do tego dochodzi nowe gniazdo Intela LGA1954(pierwsza gen NovaLake) gdzie także na 4 generacje(2 pełne generacje + 2 odświeżenia(~4 lata)) przewidziany jest wyłącznie standard DDR5. Także nic tylko się cieszyć i wyczekiwać Zen6 i Zen7
-
Nie chcę niczego wróżyć(negatywnie czy pozytywnie). Zobaczymy, jak to się potoczy. Liczyłem na jakieś szczegóły dotyczące rdzenia Zen6, ale niestety – nic z tego. EDIT: