
AMDK11
-
Postów
261 -
Dołączył
-
Ostatnia wizyta
Treść opublikowana przez AMDK11
-
Noctua wchodzi w AiO
AMDK11 odpowiedział(a) na trepek temat w Chłodzenie, obudowy, zasilacze i modyfikacje
Bo ma działać jak każdy inny komponent. Czy ktoś ocenia estetykę elektroniki monitorów EIZO? Raczej nie, bo estetyka jest podporządkowana funkcjonalności, a nie odwrotnie. Tak to widzę, a przynajmniej tak mogłoby być, gdyby specyfikacja była dobra, a urządzenie wydajne. Kupując komponent, chcę, żeby dobrze działał, a nie zachwycał wyglądem. Zawsze mi się podobała, zwłaszcza że Noctua nie da się pomylić z żadną inną marką. Chłodzenia i wentylatory od Noctua zawsze sprawowały się świetnie. Co do wyglądu to są gusta i guściki. -
Z mojej analizy wynika, że jeśli zależy Ci na żywotności i stabilności procesora, najlepiej pozostawić pamięć RAM DDR5 na ustawieniach fabrycznych procesora(np 5600 2x16GB). Wszystko powyżej tych ustawień na GraniteRidge oznacza podkręcanie (OC) i wyższe napięcia. Co skraca żywotność o 10%(nawet przy minimalnym OC). Im wyższe napięcie tym krótsza żywotność dla 1-5+%((DDR5 6000) zależnie od testu) wyższej wydajności.
-
Ciekawostka: AMD oficjalnie podaje że implementacja SMT w rdzeniu Zen4 i Zen5 zajmuje mniej niż 5%.
-
Użyłbym mocniejszego zasilacza, zwłaszcza w pierwszym przypadku, nawet biorąc pod uwagę brak dedykowanej karty graficznej. Zwłaszcza jeśli system jest używany do pracy i działa przez większość czasu. Edit: Mam kolejną ciekawostkę co do Front-End po długiej analizie Zen5: Zen5 ma pobieranie 2x 32Bajty na cykl z L1-I 32KB 8-Way (Zen 4 ma 1x 32Bajty), Dekoder 2x 4-Wide (Zen4 1x 4-Wide), OP-Cache 2x 6uops na cykl(Zen4 1x 9uops) i okazuje się że Zen5 może dla: ST: 32Bajty z L1-I, dekoder 1x 4-Wide i OP-Cache 1x 6uops SMT: 64Bajty z L1-I, dekoder 8-Wide i OP-Cache 12uops Za to dla ST i SMT jest: 6ALU(Zen4 4ALU), 4AGU(Zen4 3AGU), 4FP+2StoreFP(Zen4 3FP+2StoreFP) i ścieżki FP 512b (Zen4 ścieżki FP 256bit). Mimo klastrowego front-endu Zen5, scheduler Integr jest zunifikowany dla 6ALU i to poraz pierwszy w historii AMD. Wcześniejsze generacje do Zen4 każdy z portów ALU miał osobny scheduler. Teraz Zen5 ma jeden dla wszystkich 6ALU co jest optymalne dla ST, ale bardziej skomplikowane. Dobrą rzeczą jest to, że bardzo zaawansowany i rozbudowany nowy predyktor, który przewiduje dwie kolejne gałęzie z 3 otwartymi oknami, długimi i skomplikowanymi wzorcami oraz ogromnym BTB 24K, działa zarówno w trybach ST, jak i SMT. Mimo to średni wzrost IPC dla Zen5 wynosi +16% (średnia +14% dla INT i średnia +24% dla FP). Średnia wzrostu IPC dla Zen5 w porównaniu do Zen2 wynosi +49%, w porównaniu do Zen1 +66%, w porównaniu do Excavatora +117%, a w porównaniu do Bulldozera to już 140-150%. Do tego znacznie wyższe taktowanie Zen5 i różnica jest jeszcze większa. Jestem ciekawy czy Zen6 poprawi wykorzystanie obu klastrów w ST.
-
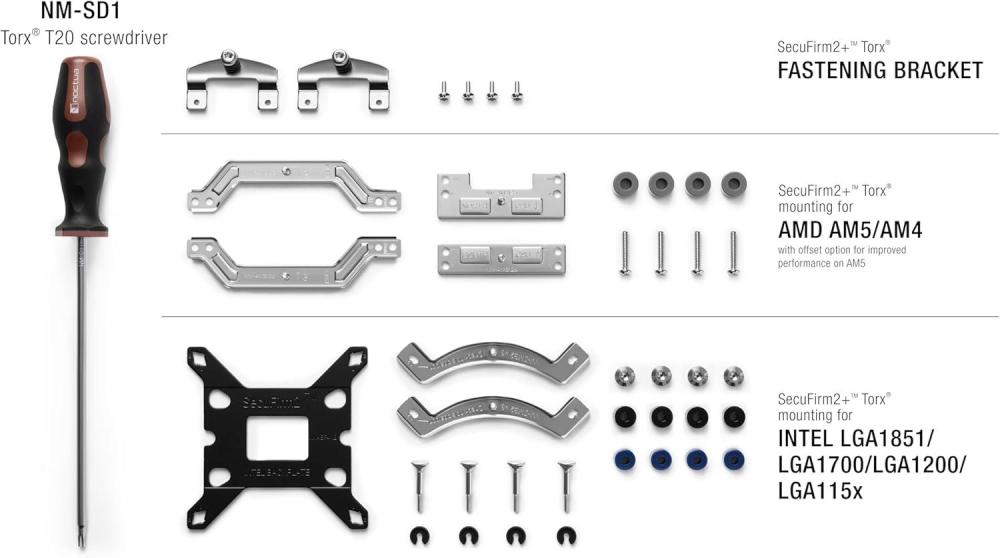
Mam właśnie chłodzenie Noctua na AM5 dla R5 9600X i mocowanie tej chłodnicy wygląda jak to na tym ASUSie. Mogę to potwierdzić w 100%.
-
Od dluższego czasu zostawiam na ustawieniach fabrycznych, bez kombinowania o każdy % wydajności. Czy te upalone były poddane OC?
-
Stary BIOS z zeszłego roku.
-
Ciekawostka: Zen 4 (Raphael) typowo (real-world, mieszany kod): ~3–4 instrukcje/cykl. sustained µops (dobry tight loop / op-cache): ~5–6 µops/cykl w praktyce; op-cache nominalnie może dostarczyć do 9 µops/cykl (teoretyczny peak). chipsandcheese.comnumberworld.org maksymalny syntetyczny szczyt: rzadko ~6 instr/cyc (laboratoryjne scenariusze). Zen 5 (Nirvana / Granite Ridge) typowo (real-world, mieszany kod): ~5–6 instrukcji/cykl (Agner: „potrafi dostarczać 6 instr/cyc w wielu przypadkach”). agner.orgchipsandcheese.com sustained µops (op-cache): w praktyce około 6 µops/cykl średnio (op-cache nominalnie 12 µops/cykl, ale nie jest w pełni wykorzystywany w większości kodu). chipsandcheese.com+1 maksymalny syntetyczny szczyt: 6 instr/cyc typowo, w idealnych mikrobenchach rzadko do ~8 instr/cyc (Agner). agner.org
-
Cytat z forum Anandtech: https://forums-anandtech-com.translate.goog/threads/thought-leadership-amd-vision-removed-official-amd-presentation.2631672/?_x_tr_sl=en&_x_tr_tl=pl&_x_tr_hl=pl&_x_tr_pto=sc
-
Może ASUS też pójdzie tą drogą.
-
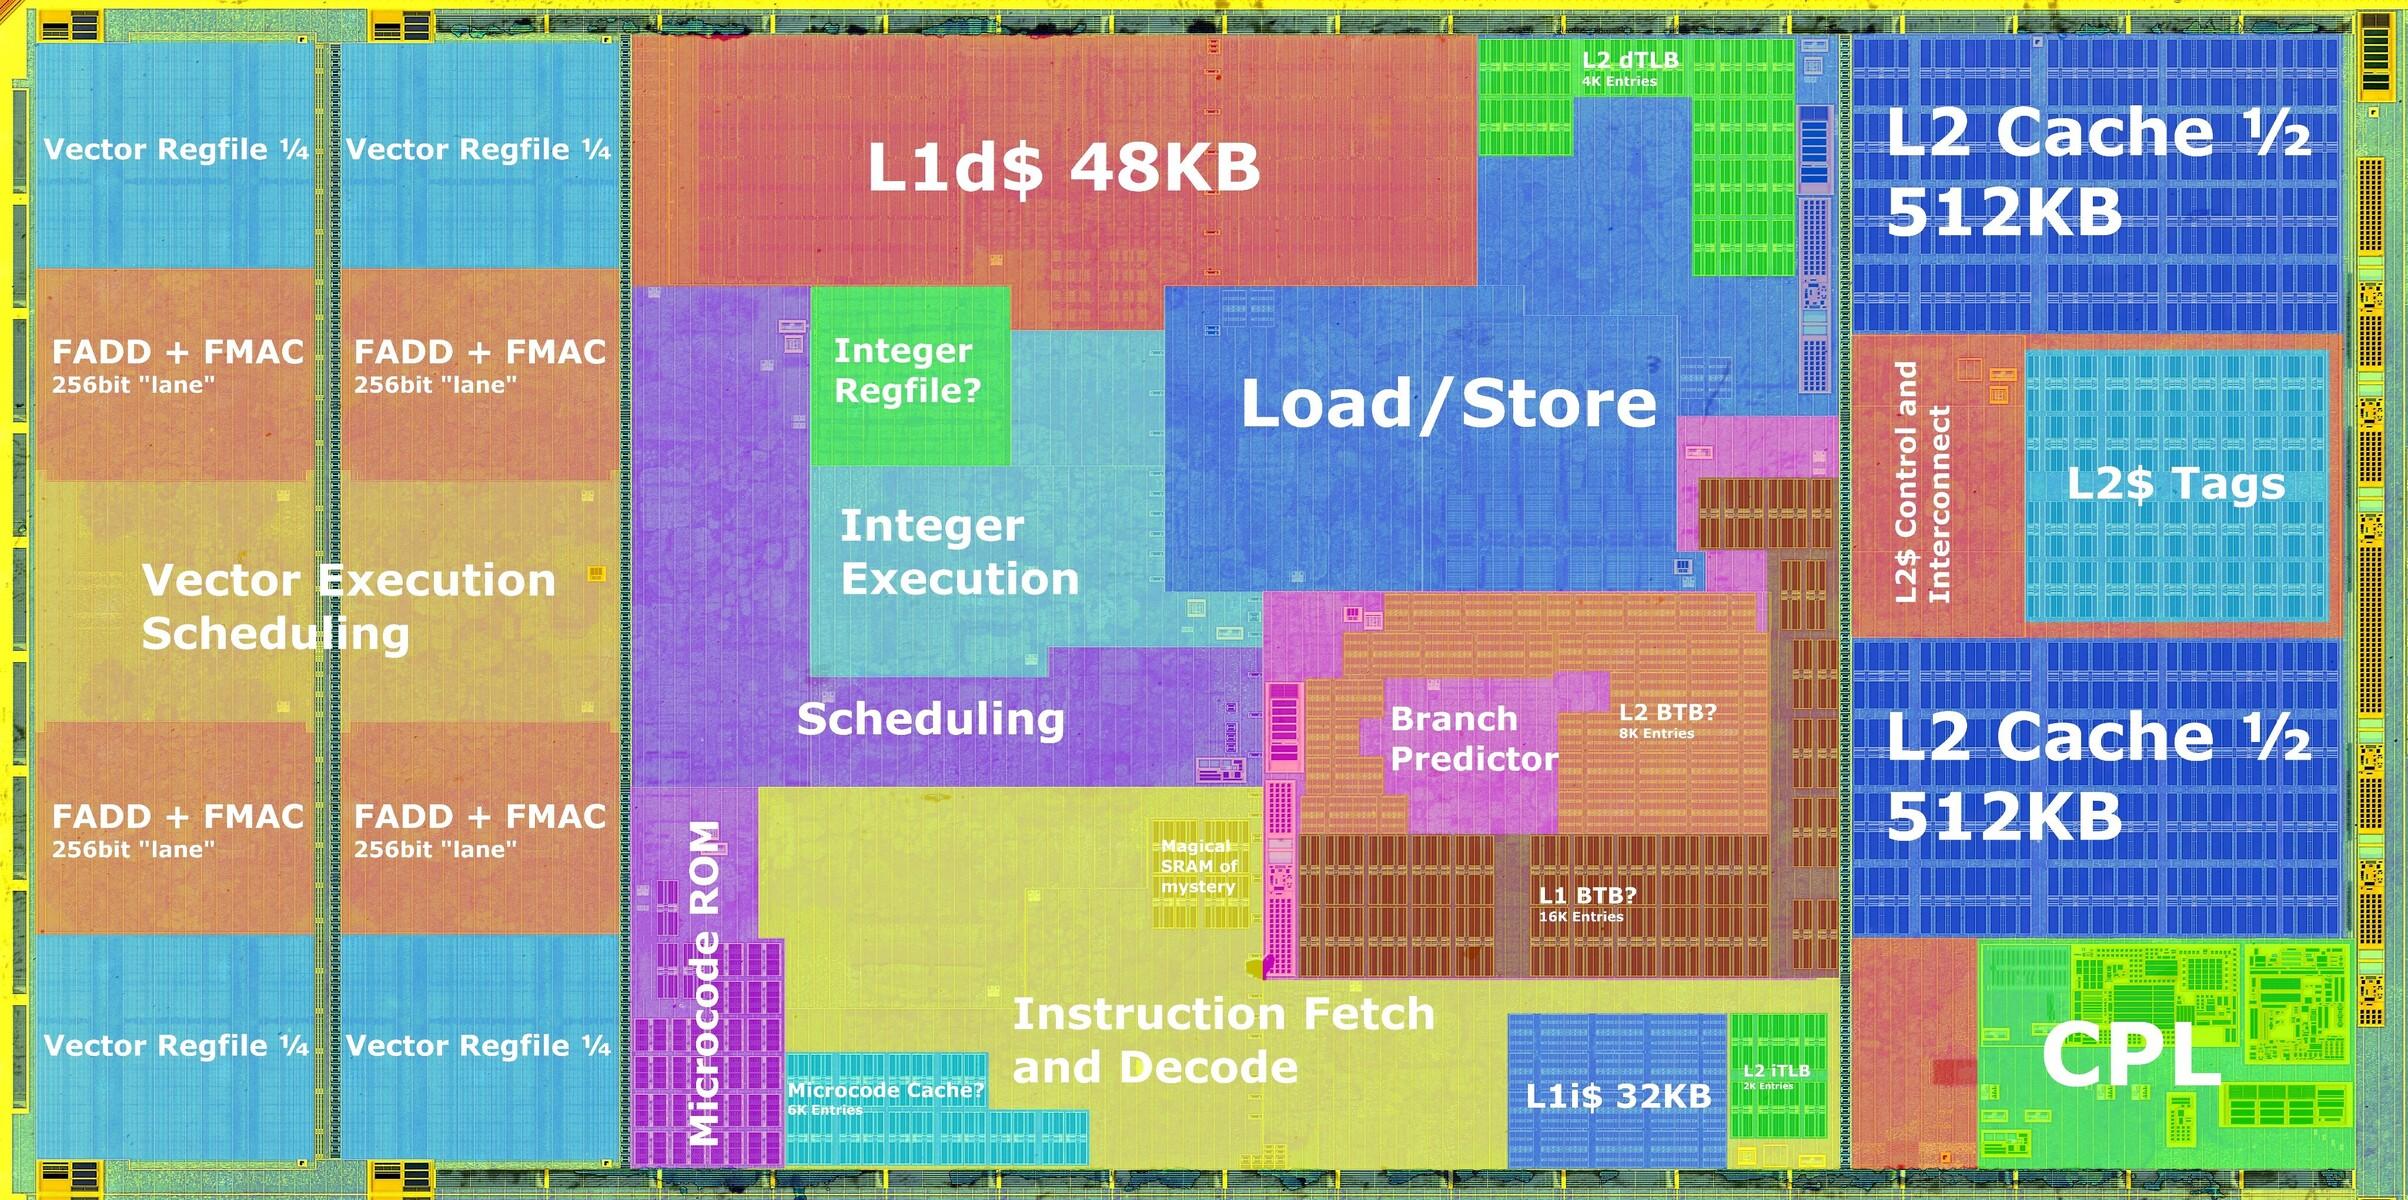
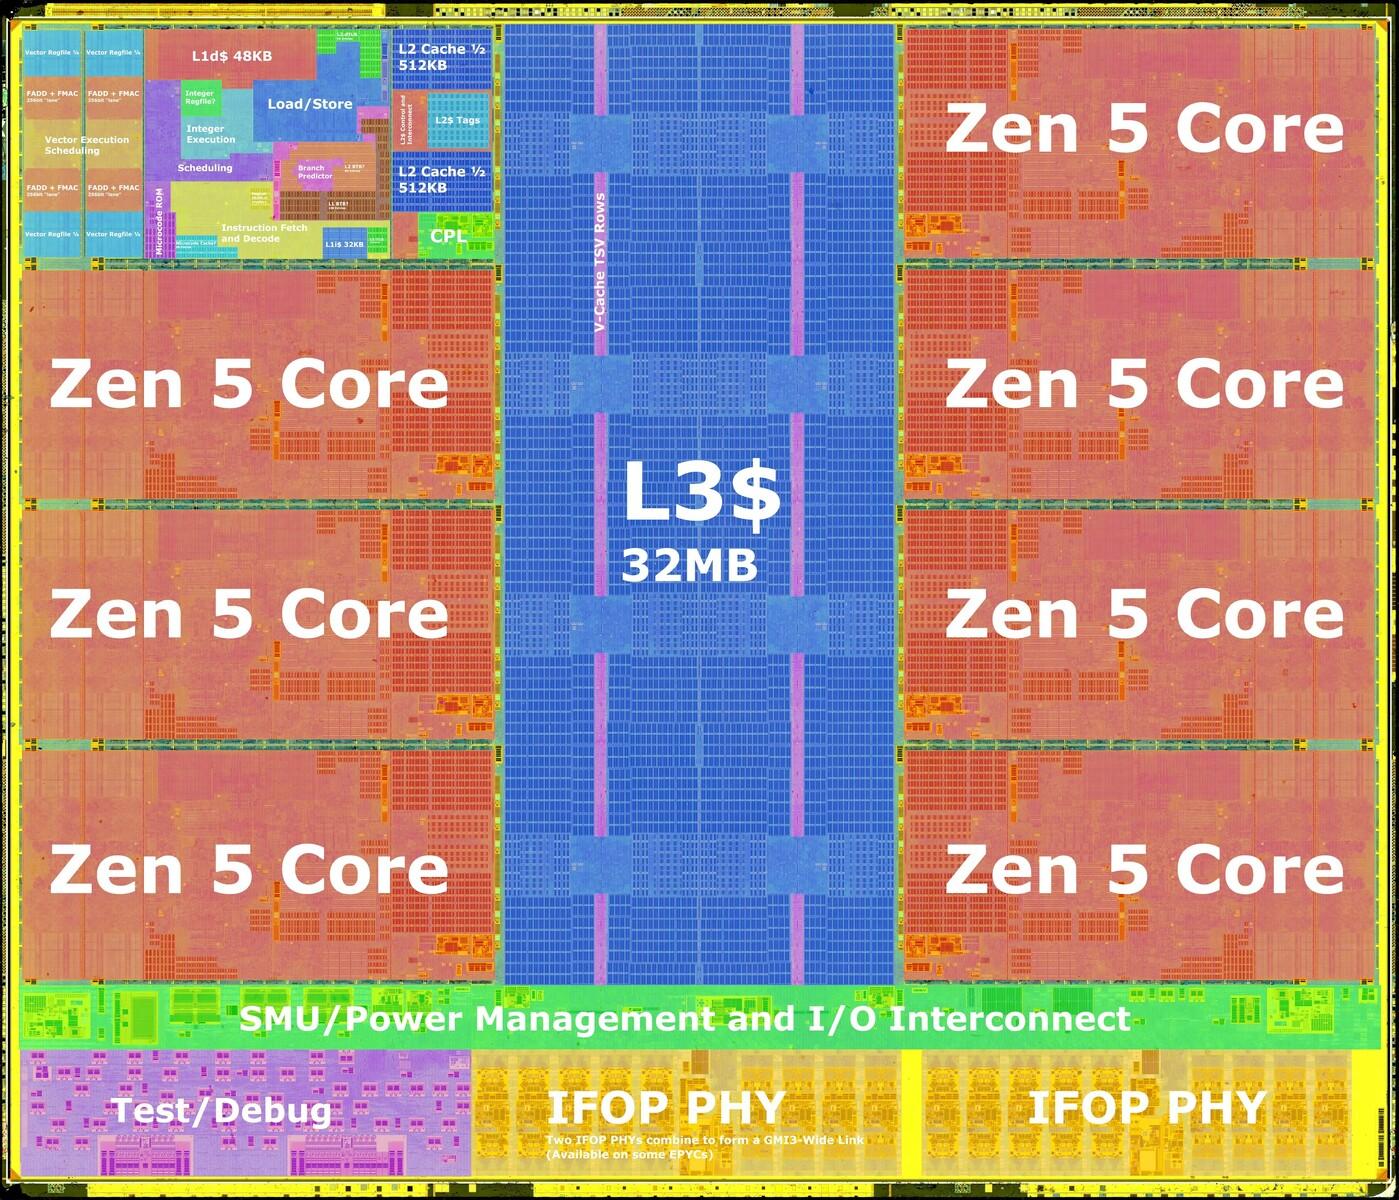
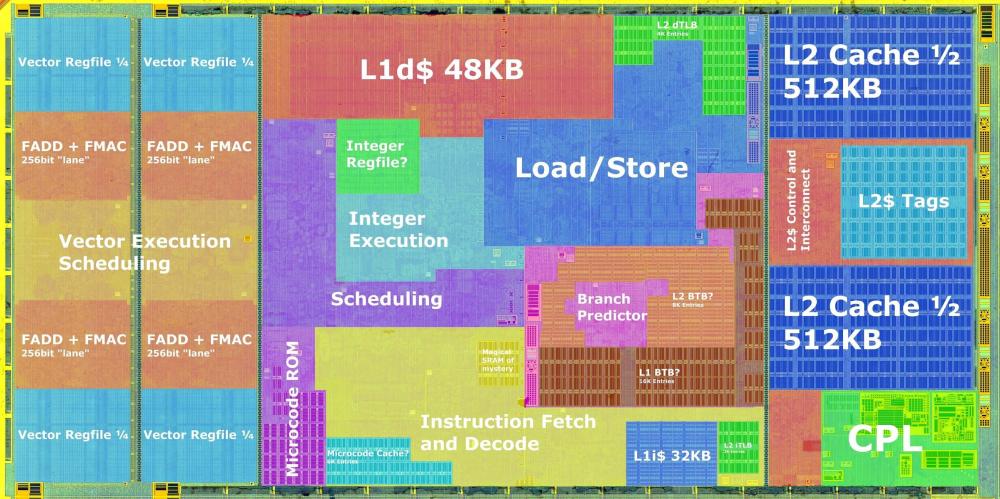
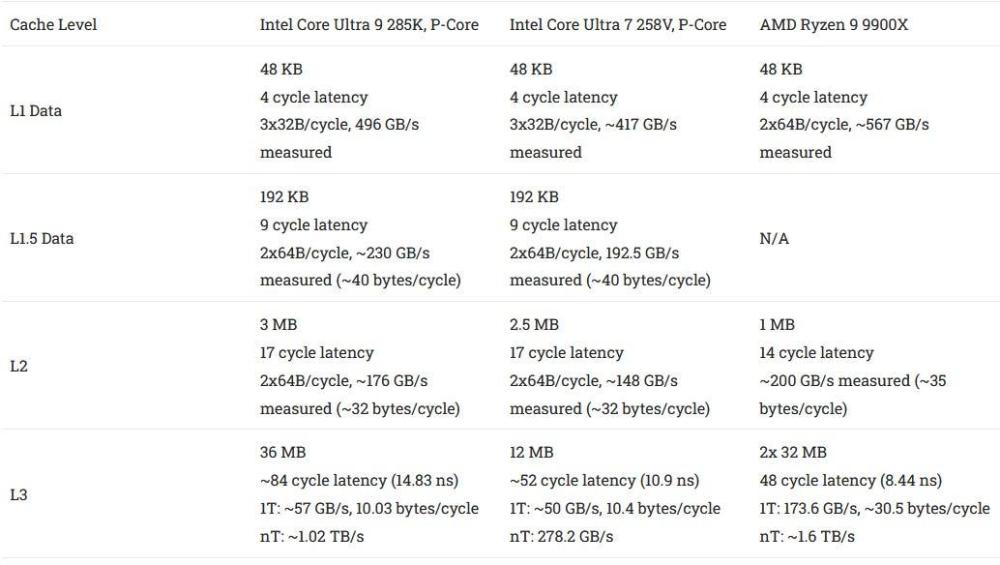
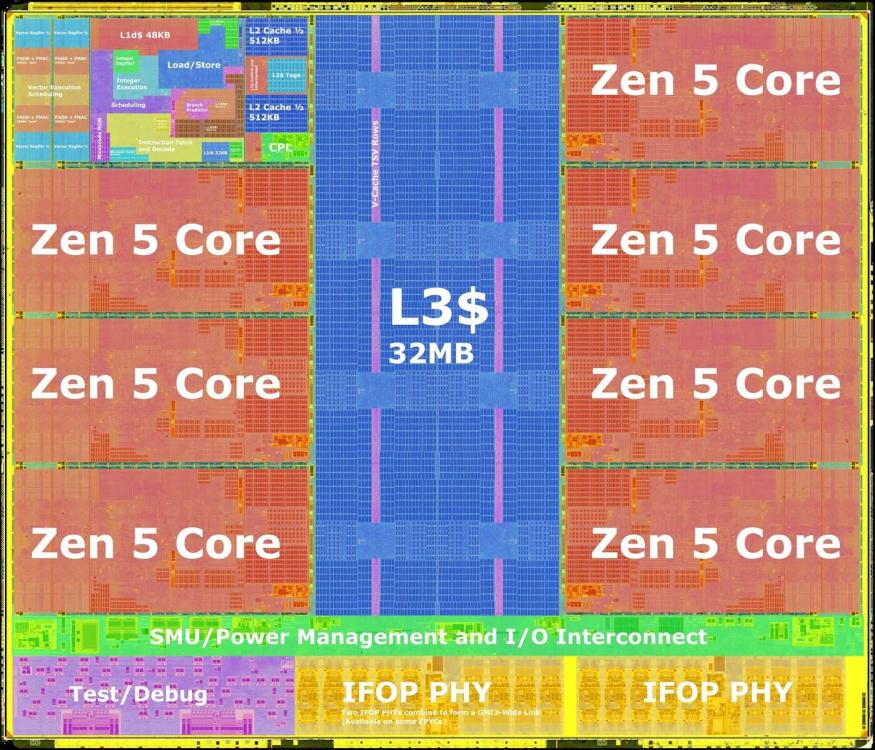
Zamieściłem ten cytat na poprzedniej stronie, ale pozwólcie, że powtórzę. Podsumowanie mikroarchitektury Zen5 po naukowej analizie: Quantifying The AVX-512 Performance Impact With AMD Zen 5 - Ryzen 9 9950X Benchmarks https://www.phoronix.com/review/amd-zen5-avx-512-9950x/2 When taking the geometric mean of the 90 benchmarks used for this AVX-512 on/off comparison, the Zen 5 AVX-512 implementation with the Ryzen 9 9950X saw its performance go up by 56% while the Ryzen 9 7950X Zen 4 with its "double pumped" AVX-512 implementation saw its performance go up by 41%. Zen 4's AVX-512 was great and now with Zen 5 it's even better with the SKUs having the full 512-bit data-path. This is especially good news for Ryzen 9000 series (EPYC 4005?), EPYC Turin, etc. Rdzeń Zen5: Po lewej, te dwie pionowe struktury to FPU(SIMD+Vector) i ogromna ilość logiki dla AVX512. Ogólnie rzecz biorąc, rdzeń Zen5 + L2 jest ogromny(ilość tranzystorów w logice). 8 rdzeni Zen5 CCD: ArrowLake 8 rdzeni LionCove + 16 Skymont:


-
Chodziło o same rdzenie x86 Zen5 + L3. Edit: Szczegółowa analiza Zen5 autorstwa Agnera Foga: https://www-agner-org.translate.goog/forum/viewtopic.php?t=287&start=10&_x_tr_sl=en&_x_tr_tl=pl&_x_tr_hl=pl&_x_tr_pto=sc Szczegóły naukowej analizy różnych mikroarchitektur Intel, AMD i Via w formie PDF: https://www.agner.org/optimize/microarchitecture.pdf#[{"num"%3A46%2C"gen"%3A0}%2C{"name"%3A"XYZ"}%2C87%2C704%2C0] Potwierdza to, co pisałem wcześniej o najnowocześniejszym i najpotężniejszym rdzeniu x86, jakim jest Zen5
-
Czy wiecie, że Zen5 to całkowita przebudowa i rozbudowa rdzenia? Zen5 to sprytnie i przemyślanie zaprojektowany rdzeń. LionCove to nakoksowany pustak w porównaniu z Zen5. Zen5 to najbardziej zaawansowany i sprytny rdzeń x86.
-
Ciekawostka: Rdzeń Zen5 został przebudowany i znacząco poszerzono w nim logikę o 26% w porównaniu z Zen4, a ilość tranzystorów wzrosła o 218 milionów! Dla porównania, zmiany w pojedynczym rdzeniu Zen5 zajęły tyle samo tranzystorów, co cały rdzeń Skylake, składający się z 217 milionów tranzystorów! Głównym celem Zen5 było znaczące poszerzenie struktur rdzenia, co wiąże się z przeprojektowaniem i nową logiką sterowania. Myślę, że Zen6 i Zen7 zostaną minimalnie rozbudowane i w dużej mierze zoptymalizowane, podobnie jak Zen3.
-
Tak naprawdę nie ma znaczenia, czy bazą jest E czy P, bo ostatecznie będzie to po prostu rdzeń P, prawdopodobnie zawierający najlepsze cechy obu "światów"
-
Skoncentrują się na jednym typie rdzenia, co prawdopodobnie jest dobrym posunięciem, gdyż jest znacznie tańsze w utrzymaniu i lepsze w rozwoju.
-
Na razie nic nie jest pewne i dopóki dane te nie zostaną zweryfikowane, pozostają one jedynie spekulacjami, do których należy podchodzić z dystansem. Co do Zen6 jestem bardzo dobrej myśli
-
Wątpię, ale kto wie.
-
Instruction Per Cycle(IPC). Inaczej "Instrukcje na Cykl" zegarowy procesora.
-
Gry osiągają średnio 1-2 IPC, podczas gdy Zen5 i LionCove osiągają 8(szczytowo więcej dzięki UOP Cache). W grach lepiej jest mieć najniższe możliwe opóźnienie i najwyższą możliwą częstotliwość taktowania. Opóźnienie jest znacznie redukowane dzięki dużym pamięciom podręcznym, takim jak 3D V-Cache AMD i samą logiką sterującą rdzenia obliczeniowego.
-
Myślę, że duże zyski są możliwe, ale to zależy od priorytetów. Priorytetem AMD w tej chwili jest więcej rdzeni. Z tego, co wiem, nic nie stoi na przeszkodzie, aby x86 osiągnęło znacznie wyższy IPC niż obecnie. Chociaż x86 komplikuje projekt, osiągnięcie IPC obecnego i przyszłego rdzenia ARM jest dla x86 całkowicie możliwe. Apple może teraz mieć znacznie wyższy IPC, ale projekt i techniki zastosowane w jego mikroarchitekturze nie są tak zaawansowane, jak na przykład Zen5(m.in predyktor(BPU)). Ściśle kontrolując proces pisania kodu oprogramowania, Apple upraszcza mikroarchitekturę rdzenia, co przenosi większy narzut na wysiłek pisania softu. W przypadku x86 projektanci rdzeni muszą jednak wykazać się umiejętnościami i pomysłowością a nawet geniuszem, aby poradzić sobie z uniwersalnością, zmienną długością i chaotyczną naturą instrukcji w każdym strumieniu oprogramowania. Z drugiej strony, x86 jest znacznie bardziej wszechstronny i nawet dodając nowe instrukcje nie trzeba się martwić, że nowy rdzeń x86 z nowymi instrukcjami nie będzie już kompatybilny z poprzednim oprogramowaniem. Moim zdaniem ciągłe spory i kłótnie o to, który x86 czy ARM jest lepszy, są bezcelowe. Apple Mx to inny cel i bardzo wąska grupa użytkowników. 99% z nich nie ma pojęcia, jaki procesor jest w nim zainstalowany ani jaką ma mikroarchitekturę. Nikogo nie obchodzi, czy osiągnął daną wydajność przy taktowaniu 2 GHz czy 10 GHz, czy ma cztery, czy dziesięć potoków dekodujących na rdzeń itd. Priorytety rynku x86 są zupełnie inne, ponieważ ARM nie stanowi znaczącej konkurencji. Dla AMD i Intela priorytetem są procesory Epyc/Xeon i urządzenia mobilne. AMD projektuje x86 Zen z silnym naciskiem na Epyc, o czym świadczy Zen5, który także musi działać dobrze w mobile. Oczekuje się, że Zen6 przyniesie mniejsze ulepszenia, ale między innymi o 50% więcej rdzeni i pamięci podręcznej. Prawdopodobnie trochę zwiększy taktowanie. Dodając więcej rdzeni i pamięci podręcznej, AMD musi zrównoważyć złożoność samych rdzeni. Apple ma tylko kilka dużych rdzeni na chip, co zapewnia większą swobodę rozbudowy mikroarchitektury. Co więcej, Apple spowolniło teraz rozbudowę rdzenia i zwiększa taktowanie. AMD i Intel walczą ze sobą o osiągnięcie jak największej ilości rdzeni na gniazdo, co zostawia małe pole do rozbudowy. Intel już zaprojektował potężny rdzeń, 3-4 razy bardziej złożony niż GoldenCove i prawdopodobnie bardziej rozbudowany i szerszy niż jakikolwiek ARM, ale porzucił projekt, ponieważ nie chciał marnować krzemu wyłącznie na procesory do komputerów stacjonarnych lub urządzeń mobilnych, gdzie można było wykorzystać prostsze rdzenie i osiągnąć „stały” wzrost generacyjny. AMD i Intel to korporacje, a akcjonariusze chcą widzieć stały, niezawodny i stabilny wzrost. Bardzo duży wzrost złożoności rdzeni w ciągu jednej generacji oznacza dłuższy czas projektowania i walidacji oraz większe ryzyko błędów. AMD i Intel mają własną ścieżkę rozwoju dla x86. Siła x86 tkwi we wstecznej kompatybilności, uniwersalności i miliardowych ilości softu(w tym otwartych i darmowych) działających natywnie na x86.
-
To jest TigerLake, czyli rdzenie WillowCove(x86 SunnyCove z przeprojektowanym podsystemem cache L2), ale z 1,25 MB pamięci podręcznej L2 (non-Inclusive) zamiast 512 KB (0,5 MB) (Inclusive). CometLake(rdzenie x86 Skylake) ma tak jak poprzednie generacje L2 typu Inclusive. Pamięć non-Inclusive to ten sam typ pamięci, który zastosowano w Skylake-X, który w części aplikacjach odnotował regresję w porównaniu z oryginalnym Skylake-S. Średni IPC WillowCove z pamięcią podręczną L2 non-Inclusive jest o około 5% niższy niż SunnyCove z pamięcią podręczną L2 Inclusive, ale TigerLake ma znacznie wyższe taktowanie. Podejrzewam, że Intela proces litograficzny 10nm charakteryzował się raczej niskim uzyskiem i słabymi parametrami, aby nadawał się do procesorów stacjonarnych. Woleli skupić produkcję 10nm dla mobilnych układach IceLake(SunnyCove), TigerLake(WillowCove) i serwerowych Xeon. IceLake jak i TigerLake jest niestety tylko na BGA. Prawdopodobnie RicketLake ma IMC(Kontroler RAM) żywcem przeniesiony z mobilnego IceLake. Kontroler RAM i Ring-Bus są słabym ogniwem RocketLake w skalowaniu dla 8 rdzeni. Ale pojedynczy wątek osiąga konkretny wzrost IPC(Średni IPC INT ~16% i FP ~24%), jakiego można spodziewać się po nowej generacji.
-
A ja głupi myślałem że będzie owalny lub w krztałcie przekroju jajka
-
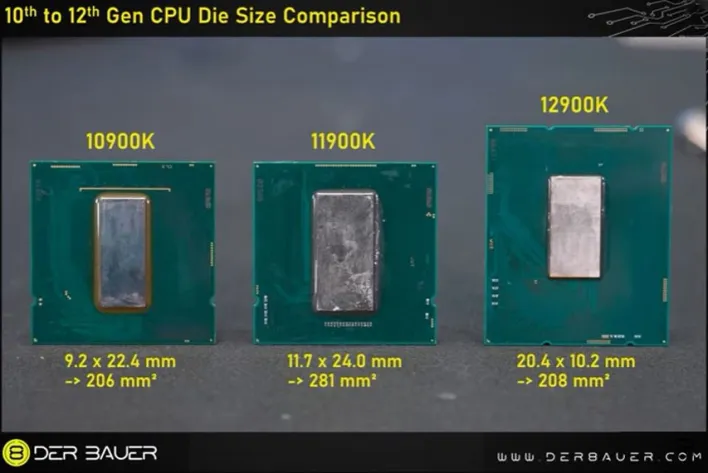
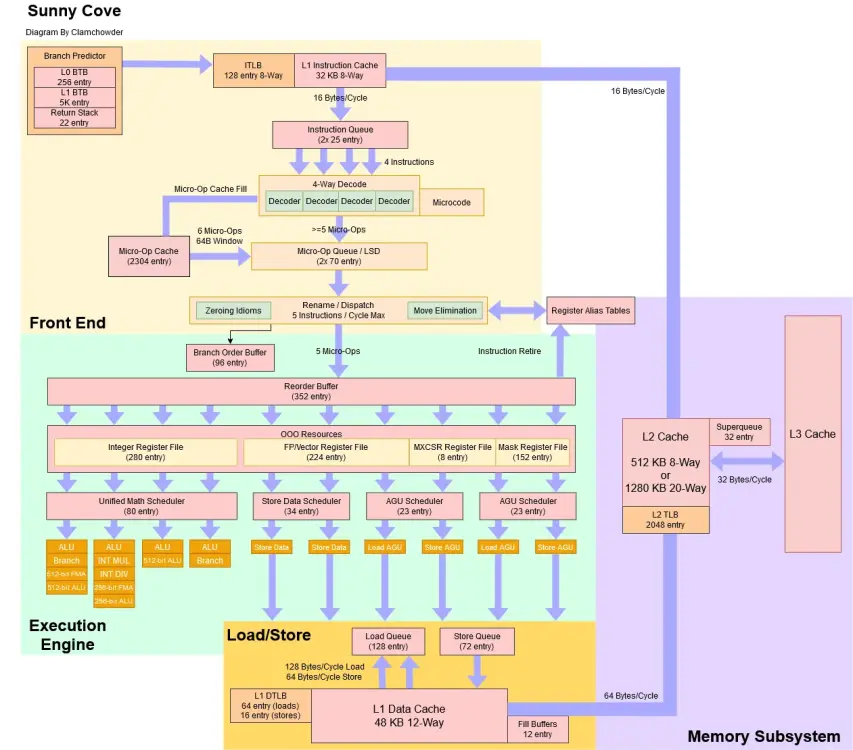
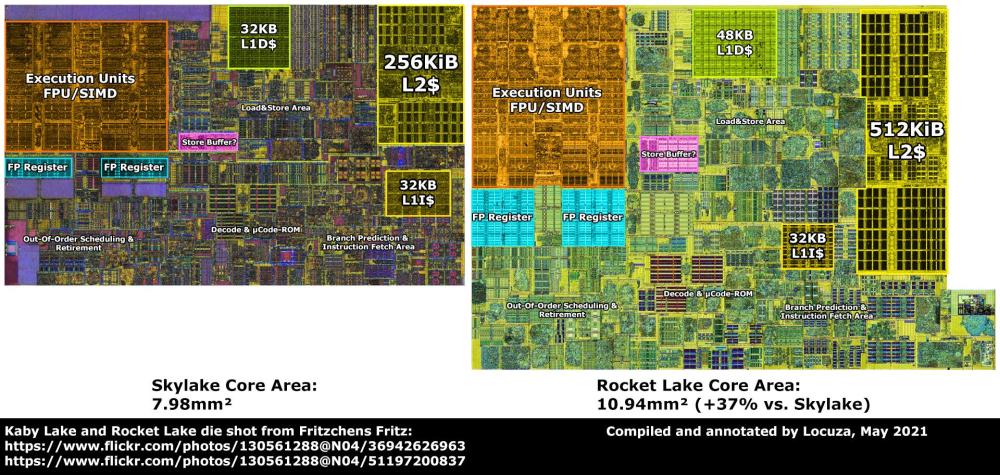
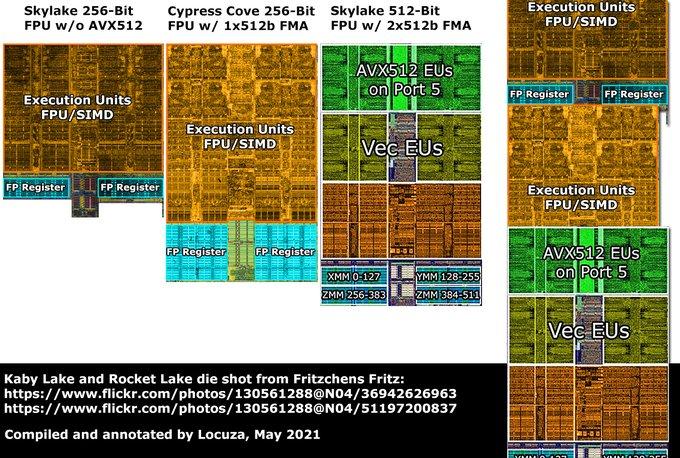
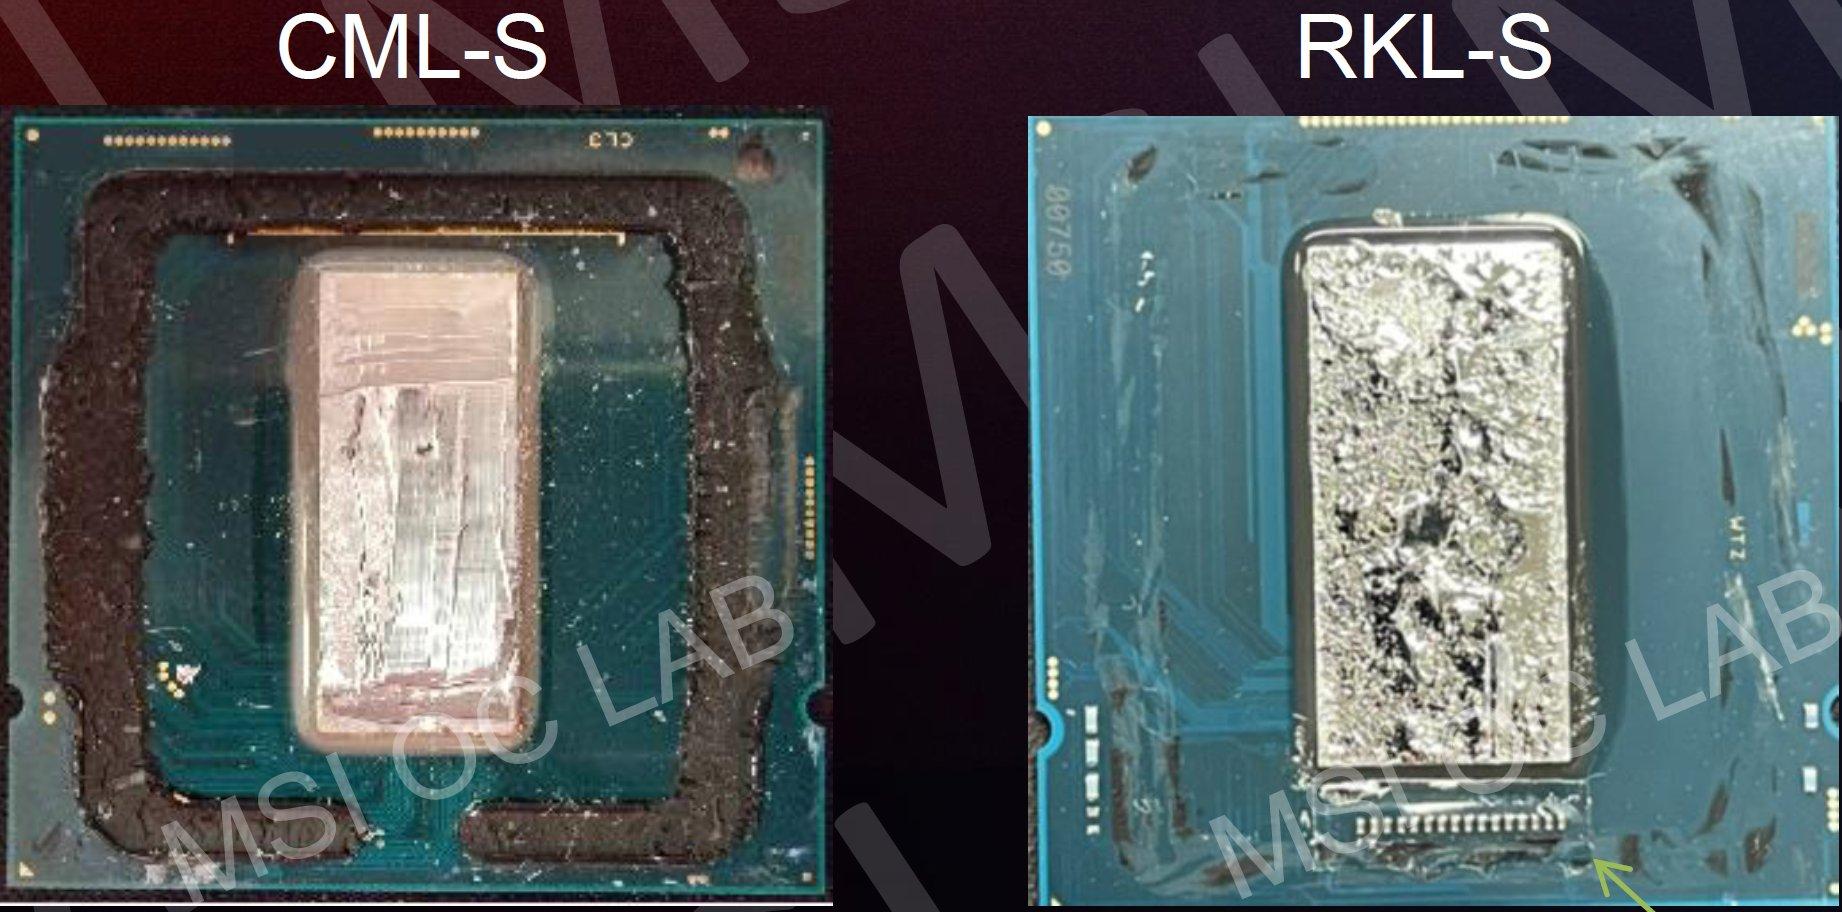
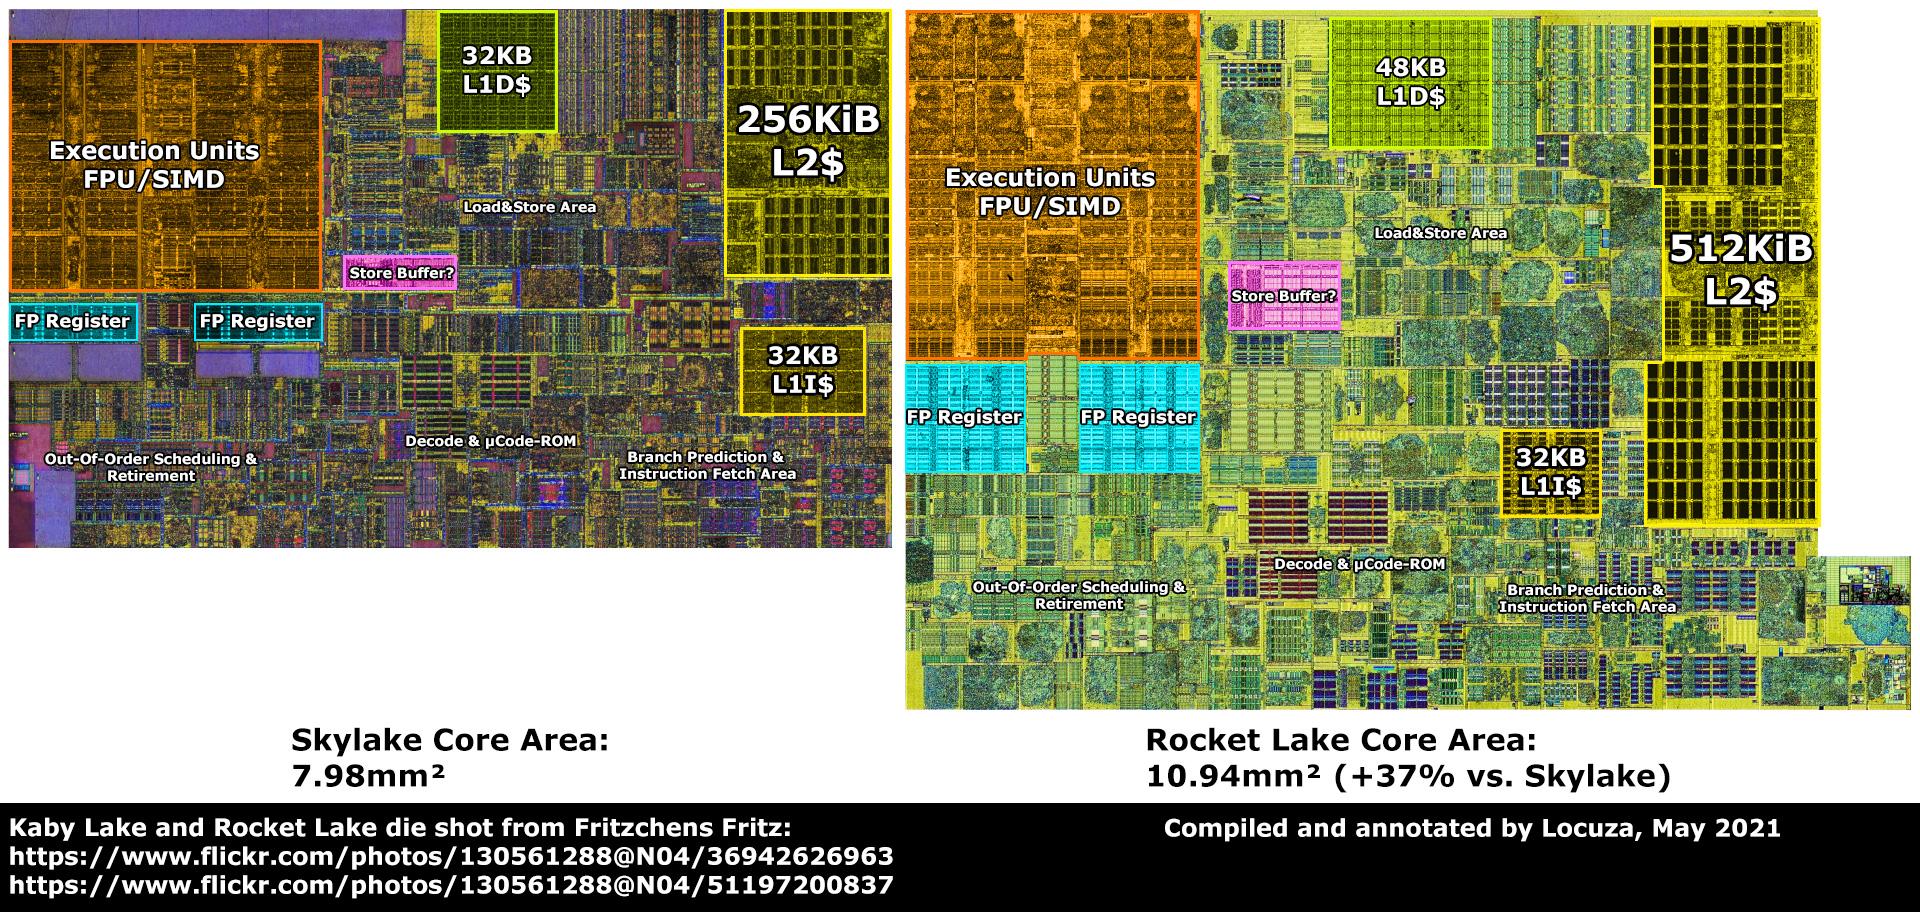
RocketLake bazuje na rdzeniach SunnyCove x86 przeniesionych(1:1) z 10 nm do 14 nm pod nazwą kodową CypressCove. Rdzeń SkyLake składa się z 217 milionów tranzystorów. Rdzeń CypressCove składa się z ~300 milionów tranzystorów, co oznacza, że jest bardziej złożony od Skylake o 38%. Rdzeń CypressCove x86 (SunnyCove) to kolejny duży skok generacyjny po SkyLake. CypressCove ma średni wzrost IPC dla pojedynczego wątku (ST) Integer (ALU) o 15-16%, a wzrost FP wynosi ~24%! Na dodatek ma implementację AVX512!(podobną do tej z Zen4 czyli 2x256bit) Ale CometLake, pomimo przestarzałych rdzeni, ma ich o 25% więcej, co przeważa nad zyskami IPC i słabym skalowaniem (szczególnie INT) CypressCove. Problemem w RocketLake jest skalowanie Integer dla wszystkich 8 rdzeni, co daje ~5% zysku w porównaniu do 8 rdzeni Skylake. Jeśli chodzi o FPU, skalowanie jest znacznie lepsze, ponieważ osiąga wzrost o 16-18%. Problemem jest prawdopodobnie m.in niższa prędkość zegara Ring-Bus. Mikroarchitektura SkyLake pojawiła się w 2015 roku, a prace nad SunnyCove startowały w 2016 roku i trwały do około 2018 roku. Rdzeń Cypress/SunnyCove jest bardziej zaawansowanym rdzeniem x86 niż SkyLake. Przegrywa, ponieważ RocketLake maksymalnie ma do 8 rdzeni względem 10-rdzeniowego Skylake w CometLake. Czemu tak jest? Odpowiedź na to jest bardzo prosta. 8 rdzeni CypressCove w 14 nm, zajmuje powierzchnię taką jak hipotetyczny 11-rdzeniowy Skylake!!! Gdyby RocketLake miał 10 rdzeni zajmowałby powierzchnię porównywalną z 14 rdzeniami Skylake!!! Praktycznie zawsze, przy dużej rozbudowie rdzenia, przechodzisz na niższy proces litograficzny, który kompensuje większą złożoność projektu (tj. więcej bramek logicznych (tranzystorów)). W przypadku RocketLake proces litograficzny pozostał taki sam jak w CometLake, a to zawsze skutkuje drastycznymi kompromisami, których końcowy efekt wygląda tak jak wygląda. Jeśli chodzi o mnie, gdybym miał wybierać, wziąłbym RocketLake, którym fajnie byłoby się pobawić, bo jestem entuzjastą. CypressCove to zdecydowanie bardziej zaawansowany rdzeń x86, w porównaniu do już wyeksploatowanej i serwowanej do znudzenia przez Intel mikroarchitektury SkyLake. Ale to zależy od tego, czego oczekujesz i czy te dane mają dla Ciebie znaczenie. RocketLake-S 8 Rdzeni: Porównanie układu krzemowego CometLake-S 10 rdzeni do RocketLake-S 8 rdzeni: W Cinebench 2024: ST 1 rdzeń Skylake 78p MT 10 rdzeni Skylake 792p(+1.8%) ST 1 rdzeń CypressCove 100p(+28%!!!) MT 8 rdzeni CypressCove 778p EDIT: Intel Microarchitecture Cache Comparison Component Haswell Skylake Sunny Cove L1D Cache 32KiB 32KiB 48KiB L2 Cache 256KiB 256KiB 512 KiB L2 TLB 1024 1536 16 (1G)2048 (4K) 1024 (2M/4M) 1024 (1G) µOP Cache 1.5KµOPs 1.5KµOPs 2.25KµOPs Intel Microarchitecture Cache Comparison Component Haswell Skylake Sunny Cove ROB 182 224 352 In-flight loads 72 72 128 In-flight stores. 42 56 72 Porównanie powierzchni tej samej mikroarchitektury tylko w różnych procesach litograficznych SunnyCove(10nm) i CypressCove(14nm):