musichunter1x
-
Postów
3 331 -
Dołączył
-
Ostatnia wizyta
Treść opublikowana przez musichunter1x
-
 Nvidia niby chwali się, że skutecznie upycha pewne dane do cache... Deweloperzy od czasów Ampere mogę wydzielać fragment L2, aby był "trwalszy" choćby dla jakiś kluczowych danych DLSS. Rozchodzi mi się o wielkość takich danych, które są tam upychane przy pomocy L2 Persistence, dodanym w Residency Control. Stąd mój logiczny wniosek, że jeśli karta nie zmieści elementów, które skorzystałyby z trwałego L2 to musi być jakiś przestój. Mogę mylić się co do wielkości tych danych, bo to próbowałem oszacować przy pomocy AI. Szkoda że dopiero teraz doprecyzowałem swoją tezę
-
Dobra, sam zmęczyłem się tą rozmową, a uciekło już meritum... Więc powtórzę sedno: Skupiam się na kwestii opóźnienia wywołania danych z Vram, gdy akurat nie ma potrzebnych danych w cache, bo nie zdążyło ich przerzucić lub całość nie mieści się na raz. Dawniej karty skupiały się na intensywnym mieleniu danych, szybko zastępując cache następną porcją, aby jak najszybciej wykarmić rdzenie. Teraz mogą zarezerwować fragment cache pod daną strukturę danych, aby zawsze była na miejscu, gdy jest potrzebna, bez czekania na wywołanie Vramu i przesłanie tego dalej... Dlatego wspominam L2 Cache Residency Control. Również więcej elementów może być wywołanych "bezpośrednio" z Vramu, co zrobiło miejsce na inne elementy..., a raczej zwiększyło skuteczność upakowania danych bez przestoi. Dlatego wspomniałem o usprawnionym asynchronous compute w Ampere, które pozwala pominąć rejestr, kopiując dane w tle. Rzucając tymi szacunkami użycia cache przez DLSS chciałem, aby ktoś zweryfikował w jakim stopniu zużycie pokrywa się z rzeczywistością... Nie dostałem żadnych informacji ile danych ładują katy do cache na rzecz DLSS, tylko ciągle przypomnienia "jak działa cache", gdy cały czas chodzi mi o redukcje przestojów przez umieszczenie danych w cache na czas...
-
Nie no Tomcug, ty też. Przecież ja nie mówię że zwiększenie cache to rozwiązanie na wszystko i boost wydajności, tylko że gdy zabraknie cache na zamieszczenie konkretnych, potrzebnych danych w konkretnym momencie to powstanie przestój. Nawet wyżej podałem funkcję, która może przyczynić się do lepszego zarządzania cache przez Ampere - L2 Cache Residency Control. W tym co podałeś nie ma nic o tym, ile zajmują elementy z bufora poprzedniej klatki itp. Na dodatek Ampere wprowadziło sprawniejsze "asynchronous compute" co m.in. trochę odciążyło cache. To wszystko właśnie służy minimalizowaniu przestojów...
-
@SebastianFMPrzecież nie o tej podstawie jest dyskusja... Tak, przetwarzane jest małymi fragmentami, sam to wspominam i nie wiem po co w innym komentarzu pisałeś o całym pliku DLSS, gdy chodziło mi o przechowywanie elementów z poprzedniej klatki w cache. Od Ampere mogą decydować o zarządzaniu danymi w cache, bez poleganiu na samej automatyce układu. CNN miało właśnie mniejsze fragmenty, transformer stara się patrzeć "całościowo" na piksele, stąd większy rozmiar danych, któe mogą skorzystać z niskich opóźnień. Tak, dane są ładowane do cache na bieżąco, "rozłożone w czasie"... Chodzi właśnie o redukcje przestojów przez poprawę zarządzania tym, co ma się znaleźć w L2 i zapobiegnięciu usunięciu potrzebnych danych przy ładowaniu kolejnych. Pewne dane skorzystają na planowanym umieszczeniu w cache dzięki niższym opóźnieniom... Właśnie na tym zyskuje m.in. DLSS oraz RT. Serio niektórzy nie rozumieją, że od Ampere trochę zmieniło się, gdzie Ada umożliwiła ciekawszą utylizację L2 przez większy rozmiar... Developerzy mogą tego nie optymalizować, skoro konsole nadal siedzą na paru MB. Edit. Sam już nie wiem, kto jest tu ignorantem ja czy reszta. To o czym mówię jest możliwe od czasu wprowadzenia m.in. L2 Cache Residency Control. Od tamtego czasu GPU nie używa cache tylko jako strumienia, teraz może być wydzielone "trwałe" miejsce na dane, które skorzystają na trochę dłuższej obecności lub zagwarantowanym miejscu. Piszecie tak, jakby to było niemożliwe. @sidebandMógłbyś odnieść się do L2 Cache Residency Control? Na dodatek powtórzę - nie zrozumieliśmy się w przypadku "wspólnego L2". Przecież nie chodzi o fizyczne położenie L2, lecz o wspólne adresowanie danych dla "wszystkich rdzeni". W CPU są oddzielne dla każdego rdzenia, w GPU tak nie jest.
-
Ale ja to wiem... Chyba ciągle obracasz się w czasach sprzed Ampere, gdzie wprowadzili L2 Cache Residency Control. Chodzi o to, że obecnie jest tak używany do niektórych danych, bo można wcześniej zaplanować jakie będą potrzebne... Zamiast czekać aż karta będzie potrzebowała np. elementów bufora z poprzedniej klatki, to można załadować je tuż wcześniej, w odpowiednim momencie lub po prostu zadbać by miało miejsce / zapobiec ich usunięciu z cache. Tak to karta sprawdziłaby czy jest w L1, L2 i wydała żądanie o przesłanie z Vramu, co spowodowałoby mały przestój przez czekanie na dużo wolniejszy Vram... Edit. Serio już myślałem że pogubiłem się przy sprawdzaniu tematu, ale po prostu nie rozumiecie co mam na myśli, bo ciągle mówicie o funkcji cache sprzed Ampere... Teraz przynajmniej mam przypuszczenie co do kolejnego elementu przyczyniającego się do gorszej wydajność m.in. DLSS na Turing.
-
Dla mnie cache to po części taki odpowiednik kondensatora, ale mam wrażenie że kompletnie pomijasz większą ilość i wagę elementów które obecnie tam trafiają... Karta doładuje sobie potrzebne dane z Vramu, ale problemem są opóźnienia. Ada usprawniła również zarządzanie wymianą tych danych... Nie skupiasz się przypadkiem na samej roli cache jako ""kondensatora", nie biorąc pod uwagę jakie elementy tam trafiają i co się dzieje gdy nie są tam w całości lub na czas? Bo nie musi mieć 2 razy wiekszego cache? Przecież nie to argumentuję... Z czym się tutaj kłócisz, bo sam już nie wiem... Jeśli cache nie starcza na raz to GPU czeka aż Vram dośle potrzebne rzeczy i wtedy jest mały przestój o ten czas potrzebny na dosłanie. Nvidia mogła tak dobrać przypadek testowy, by nigdy nie przekroczyło, aby mieć czyste dane o mocy obliczeniowej.
-
? Ale rozumiesz że FPS nie skaluje się liniowo z cache? Jeśli potrzebne dane mieszczą się to nie ma dodatkowych opóźnień wynikających z czekania na Vram. Jeśli cache wystarcza to wydajność zależy tylko od mocy obliczeniowej, a wątpię by Nvidia pokazała tabelkę na przykładzie przekroczenia cache... Jak już to pewnie zakładają brak potrzeby sięgania bezpośrednio do Vramu..., bo jest za dużo zmiennych przy przekroczeniu, aby to uwzględnić w prostej tabelce... Choćby różne opóźnienia dla gddr6, gddr6x, gddr7, przepustowość, stopień przekroczenia cache, rodzaj wyrzuconych danych do Vramu... Przekroczenie cache to spadek wydajności o kilka % i potencjalne rwanie, choć zależy ile i co wrzuciło do Vramu, bo może to być większy ubytek.
-
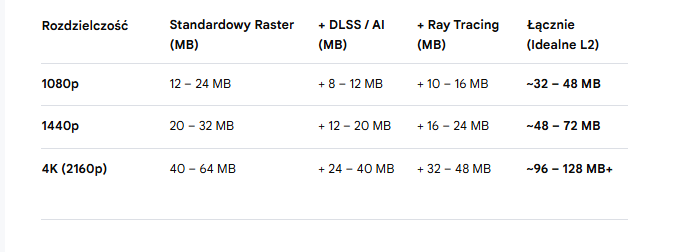
@sideband Dzięki za komentarz, ale dalej nie wiem czy się zrozumieliśmy... Przecież skądś kojarzę, że L2 jest wspólny dla wszystkich jednostek obliczeniowych... Chodzi mi o sposób obsługi, a nie budowę, gdy mówię o "wspólnym" L2. Wiem że cache ma niby nadrobić przepustowość pamięci od Ady, ale chodzi mi magazynowanie w nim elementów wymagających szybkiego dostępu... Ponoć od czasów Ampere można "rezerwować" cześć L2 np. dla elementów DLSS - wagi sieci neuronowej, wektory ruchu, buforowanie poprzednich klatek, gdzie w L2 są tylko aktualnie przetwarzane elementy lub tylko niektóre dane... Przejmowanie funkcji L1 to tylko jedna z czynności wykonywanej przez L2... Nadrabianie przepustowości to tylko jedna z funkcji... Tutaj kompletnie nie rozumiemy się, ponieważ dla mnie oczywiste jest, że chodzi o aktualnie przetwarzane elementy i małe, kluczowe rzeczy które można zmieścić w cache... Niektóre wymieniłem wyżej w tym komentarzu. Choćby cały bufor poprzedniej klatki nie będzie w cache, tylko potrzebne elementy. Edit. Na szybko z pomocą AI sporządziłem listę przykładowych rzeczy, które trafiają do cache, gwiazdka to funkcje wykonywane również przez L1: Edit.2 Również poprosiłem o tabelkę z oszacowanym zapotrzebowaniem na te elementy... Oczywiście im niższa rozdzielczość tym mniejsze zapotrzebowanie. Raczej nie bierze pod uwagę użycia FP8 w niektórych przypadkach:
-
Polecane wentylatory - testy, opinie, dyskusja.
musichunter1x odpowiedział(a) na temat w Chłodzenie, obudowy, zasilacze i modyfikacje
I dlatego właśnie dziwi mnie że prawie nie ma takich produktów... Grill ponoć ogranicza przypływ tylko o ~5%. Pewnie przy wysyłce itp. jest to bezpieczniejsze, a grill wymagałby jednego, dodatkowego kroku na produkcji... Już dawno powinni robić inne wzory, nawet nie wiedziałem że jest taka obudowa z twojego przykładu, ale to kolejne akwarium. -
? Jest cache na każdy SM - L1, L2 wspólny o którym pisałem i od biedy AMD dorobiło sobie "L3" - infinity cache. Pomaga to szczególnie mocno, gdy mieszczą się małe kluczowe elementy, co skraca czas dostępu, bo Vram ma znacznie większe opóźnienia. Skupiłem się na DLSS, ponieważ komplet danych zajmuje sporo miejsca i musi być w całości w cache, inaczej dostaje opóźnieniem z Vramu i karta czeka, choć nadal to niewiele. Gdy załaduje pewne rzeczy do cache to nie czeka potem na dostęp do nic, dzięki niższemu opóźnieniu. Nvidia wręcz chwali się optymalizacją DLSS, tak aby dane zmieściły się w cache... Edit. Doprecyzuję że chodzi głównie o DLSS Transformer, ponieważ ma "całościowy" kontekst obrazu, a nie małe, najbliższe wycinki, stąd zajmuje więcej cache lub siedzi we Vram, działając wolnej przez opóźnienia.
-
Edit. Dobra już nieważne, sideband wyjaśnił temat. Edit.2 W sumie to już nie wiem czy mam częściową rację czy nie, bo niektórzy nie rozumieją że cache zachowuje się teraz inaczej niż przed Ampere. Poczekajmy aż dodadzą RR na FP8 to wtedy 32MB pewnie nie starczy, no chyba że w 1080p. AI coś tam plecie, że RR dla presetu K to dodatkowy koszt 10-20-30MB, oczywiście zależy od rozdzielczości. FP8 powinno obniżyć to o ~połowę i wtedy będzie działać z presetem M oraz L. Dodając.... RR niby dalej działa na FP16, więc mogą zmniejszyć zużycie cache, gdy przejdą na FP8 i chyba na to czekamy? 1080p DLSS quality, preset K + RR = 28-32MB, ale może wyskoczyć poza 32MB. 1440p DLSS balance, preset M + RR = 24-28MB, quality dobija już do ~40MB 2160p DLSS performance, preset M + RR = 32-36MB, przynajmniej rtx4070 już ma 36MB To samo ale na quality = 42-48MB ALE, jeszcze inne rzeczy walczą o miejsce w L2 cache, więc dobrze mieć zapas. Ta reszta może zając 6-24MB, a może nawet więcej, bo przy natywnej pokazuje mi do ~50MB w 4k. Więc jeśli gry już wrzucają te swoje drobnostki do cache to wtedy architektury z >=32MB zyskują i takie rtx4060ti / 5060 będą lepsze od rtx3070. Edit... Jeszcze jedno dodając: PS5 i PS5 Pro maja tylko 4MB cache, więc nic dziwnego że nie mogą ogarnąć lepszego skalowania w sposób nie zjadający wydajności. Xbox Series X podobnie -5MB, Switch 2 - 4MB, więc na szeroką optymalizację do bufora trochę poczekamy...
-
Heh, pewnie znowu jestem spóźniony z tematem lub mam błędne informacje. Podłubałem trochę w temacie mieszczenia się DLSS transformer w cache. Ampere traci nawet na presecie K, mimo że używa FP16, ponieważ 4mb cache w takim rtx3070 nie pomieści transformera, a opóźnienia Vramu są wielokrotnie większe. Aby zmieścić 4K DLSS Performance preset K potrzeba ~40mb, mniejsze rozdzielczości i tryby mieszczą się w 32mb. Natomiast preset M zajmuje mniej niż 32MB przy 4K Performance, ale preset L przebija już 32mb, okolice 35-40mb.. Przy Ultra Performance preset L spada już poniżej 32mb... Więc najpewniej tutaj leży jedna z przyczyn zalecania tych presetów do trybu Performance, a drugiego do 4K UP. 48mb ma dopiero rtx4070super oraz rtx5070... Edit. RR dodaje jest swoje, więc ciekawe na ilu skończy się. Muszą dodać RR do FP8, bo inaczej dopiero 1440p DLSS Perfomance z RR ledwo nie przekracza 32mb.
-
Polecane wentylatory - testy, opinie, dyskusja.
musichunter1x odpowiedział(a) na temat w Chłodzenie, obudowy, zasilacze i modyfikacje
Recenzenci mogliby porównywać głośność wentylatorów mierząc lub oceniając hałas po przykręceniu do odpowiednika tyłu obudowy - Hexagonalny wzór otworów. Byłby to jakiś punkt odniesienia. Obecnie przeszkadza mi tylko wentylator na tyle - P12, bo powyżej 1000RPM szum robi swoje. Może pokombinuje ze zrobieniem odstępu ramką wyciętego wentylatora i przykręce to na zewnątrz obudowy, ponieważ wycięcie tej "siatki" zbyt mocno naruszy konstrukcję obudowy. Ponoć taki wzór ogranicza przepływ o 15-25% na wentylatorach które radzą sobie z oporem... Dystans 25mm nadrabia połowę strat względem braku przeszkód. Na razie zrobię taką prowizorkę, aby zobaczyć czy w ogóle coś sensownego zmieni w Rajintek Metis Plus. -
Hah, obecna teoria spiskowa to - Epstein żyje. Znaleźli jego konta z grami po mailu z dokumentów oraz był tam zakup z 2019r. Konto potem przełączono na prywatne, ale ponoć porobili zrzuty. Oczywiście konto może być tylko z jednego kraju. Na mój rozum to boty mogły skraść jego konto, ale kto tam wie. Edit. Na szczęście na zdjęciu to ponoć Timothy Gregory lub AI, wiec połowa teorii już nie żyje.
-
Politmemy, czyli wojna na polityczne memy (każdy mile widziany)
musichunter1x odpowiedział(a) na GordonLameman temat w Dyskusje na tematy różne
Dla mnie memem samym w sobie jest to, że linkuje zdjęcie Trumpa, na którym są jego dzieci - Ivanka i Eric. XD Zdjęcie zrobione w "klubie Mar-a-Lago Donalda Trumpa na Florydzie, w latach 90... " -
Politmemy, czyli wojna na polityczne memy (każdy mile widziany)
musichunter1x odpowiedział(a) na GordonLameman temat w Dyskusje na tematy różne

-
Potrzebny elektronik do naprawy mini Pc
musichunter1x odpowiedział(a) na Killer85 temat w Dyskusje na tematy różne
Do jakiegoś serwisanta - youtubera podeślij. Raczej nie policzy Cię za diagnozę, bo będzie miał temat na odcinek Możliwe że jakaś ścieżka nie łączy lub jakiś "tani" układ dostał to wtedy jeszcze coś tam zrobią. Wymiana głównego układu na pewno nie ma sensu. Byle jaki mini PC na N100 zrobi to samo, ale bez gier. -
Galeria, ciekawostki miniPC ITX mATX
musichunter1x odpowiedział(a) na Keel temat w Chłodzenie, obudowy, zasilacze i modyfikacje
Ah, gdyby tylko power limity nie postawili tak wysoko, dla rtx5060 jest to chyba 84%. Lubię zrobić sobie UV krzywą, ucinając ją dopiero w miejscu, gdy wysypuje się i wtedy tylko power limitem zmieniam zachowanie karty. Z tego powodu lubię monolity, tylko musieli przyciąć PCIE do x8... Dlatego prosiłem o test procesorów na 44w, bo taki jest limit w Ryzen Master dla PPT, przynajmniej u mnie. Gdy porównuje sobie testy to na 44w monolity prawie nic nie tracą, nawet we wymagających przypadkach, a test był bez curve optimizer, gdzie można odzyskać trochę wydajności. Miałem w planach przeskoczyć na 8400f / 8700f + rtx5060super i mieć jedno pudełko do wszystkiego, wraz z emulacją PS3, ale bańka AI uświadomiła mi, że nie potrzebuję tego. Teraz jestem ciekaw jak zachowuje się 8400f przy mniej niż 6w na rdzeń. Valve musiało znaleźć złoty punkty dla swojego AM5 przy 30w, podejrzewam że wydajność będzie podobna do ryzen 5600 lub 5500 z dobrym ramem i OC. PPT 44w dla 8400f to około 34W – 38W dla rdzeni. Jeśli ktoś ma ryzen 8400f to prosiłbym o sprawdzenie kiedy przestaje trzymać 60fps w grach, można zacząć od 17-19W i zwiększać o 3-6W. W teorii jego SOC pobiera trochę więcej niż ryzen 5500, przy ramie ponad 5200mhz, a samo ddr5 pobiera ciut więcej niż ddr4 na tych samych napięciach. Darowałem sobie próbę przeskoczenia na i5 12400f, bo przy niskim PPT będzie praktycznie to samo, a trzeba szukać lepszych płyt pod mocniejsze grzebanie w ustawieniach. Jak zabraknie mi wydajności po stronie karty to przeskoczę na rtx4070 gddr6, gdzie przy ~135w Vram powinien nie spadać z Pstate 0. 35w na CPU i 137w na GPU daje u mnie 200w poboru z gniazdka przy zasilaczu gold. Taką granicę sobie wymyśliłem, bo do 200-240w zasilacze SFX bronze 350-450w potrafią być ciche. Na dodatek jeden wentylator 120mm może cicho pracować przy wyciąganiu takiej ilości ciepła. Edit. W rozważaniach z AI, pilnując by nie zaczęła halucynować wyszło niby coś takiego... RTX3070 jestem pewien, bo sam testowałem, z rtx3060ti również miała dobre wnioski wcześniej, rtx4070 teoretyzowałem sam i wyszło mi podobnie, na podstawie innych testów z internetu, a Blackwell to już dla mnie niewiadoma. @rzymoPonownie znalazłem informację, że poniżej 890mv Blackwell miewa problemy, stąd pytałem się o zrzucenie Pstate 0, ale może chodzi o innej niestabilności lub nieproporcjonalne straty poniżej 890mv. Nic dziwnego, że Nvidia ograniczyła PL do 70%, a nie 45-50%, bo ludzie sami zrobiliby sobie Quadro na gorszych binach.
-
Capcom raczej usunie ten nowy DRM, bo próbował zrobić to w starszych grach parę lat temu, sle wycofał się po oburzeniu graczy... Więc wystawiajcie negatywy do czasu aż cofną aktualizuję lub dodadzą wersję "beta".
-
Galeria, ciekawostki miniPC ITX mATX
musichunter1x odpowiedział(a) na Keel temat w Chłodzenie, obudowy, zasilacze i modyfikacje
Serio dała radę zejść do takiego napięcia bez zrzucenia Vramu do niższego stanu? Ada wrzucała poniżej 0.91V, a modele na gddr6 poniżej 0,87V czy jakoś tak, bo Nvidia ustawiła na sztywno Pstate 0 w tych granicach. Szkoda tylko, że nie ma wtyczki od frontu jak w rtx4060 OEM... Edit. Ciekawostka ode mnie: Wcześniej myślałem, że Ryzen Master i płyta ogranicza PPT do 44w, ale w BIOS można na sztywno ustawić niżej. Ryzen 5500: -17w stare gry bez większych problemów, Arkham Knight raczej też trzyma 60fps. -22w jeśli 17w nie daje rady to 22 rozwiązuje problemy, np. coś wysypało się przy 17. -27w trzyma FPS w nowszych grach, ale nie miałem nic sensownego zainstalowanego, Cyberpunk z RT Ultra +40fps, bez 60fps, tłumy na wysokich ustawieniach. Jednak w grze potrzeba 35w do tego. -44w to często praktycznie bazowa wydajność, bo i tak rzadko przekracza 40w przy 60fps. -
Polityka w Polsce i na Świecie - wątek ogólny
musichunter1x odpowiedział(a) na Spl97 temat w Dyskusje na tematy różne
Smilk cały czas sprzedaje zagranicznie, bo tam "nie ma" problemów, w Polsce trochę kombinuje. Nie pamiętam o którym producencie była mowa. Pewnie i tak odmówisz zaznajomienia się z sytuacją, bo "ważne kto mówi, a nie co." Chodziło o dużego producenta i chciano zbyć skargi kobiet z Polski... Problem w tym że były to też kobiety po medycynie i udowodniono, że to produkt był winny, a nie jego złe przechowywanie. -
Polityka w Polsce i na Świecie - wątek ogólny
musichunter1x odpowiedział(a) na Spl97 temat w Dyskusje na tematy różne
To rozumiem że obchodzi was tylko płytkie podejście do tematu, zamiast holistycznego spojrzenia... Od lat śledzę temat żywienia i mechanizmów w ciele człowieka / chemicznych, więc argumentacja urzędnicza / tamtej strony od razu jest dla mnie absurdalna, tak jak odbiera to producent tego mleka... Ale rozumiem że nikogo nie interesuje co te normy reprezentują i skąd się wzięły... Przy sztucznym jedzeniu dla niemowląt może ma to jakiś sens, gorzej że same wymagania są z tyłka i z takich jedzonek to dziecko dobrze tego nie przejdzie. Dla was musiałbym przejść z tematem do teorii spiskowych, bo długo zajęłaby dyskusja nad tym, że prawo jest pisane pod największych producentów... Jak odmawiacie zaznajomienia to wasza sprawa... Konteksty i tak byłby na kilka godzin, dlatego rzuciłem film odnośnie badania siedmiu krajów, które doprowadziło do demonizacji tłuszczy i choćby powstania piramidy żywieniowej, z której wywodzą się m.in. normy... Jeszcze raz linkuję, ale w spoilerze, jeśli ktoś ma coś obejrzeć to właśnie to. Są inne omówienia po angielsku jeśli ktoś woli. Chyba nie wierzycie, że wszystkie promowane badania zawsze mają rację ? Nawet jak po zweryfikowaniu wychodzi inaczej to nic nie zmienia się, no prawie nic i dopiero teraz odwrócono piramidę, co też niekoniecznie jest dobre. -
Polityka w Polsce i na Świecie - wątek ogólny
musichunter1x odpowiedział(a) na Spl97 temat w Dyskusje na tematy różne
Heh, a rozumiesz o czym mówi? Pierwsze 5 minut jest prawie o niczym i tylko ględzi że podniesienie HDL nigdy nie było celem + oczywistościach, odnosząc się do dawnej propozycji Bartosza, gdzie mówił że już stosunek jednego do drugiego jest lepszym markerem. Dalej jest niewiele lepiej, a Czekała raczej nigdy nie proponował podnoszenia HDL jako terapii. Bartosz szeroko mówi również o utlenianiu się cholesterolu, czynnikach prowadzących do tego oraz zapobiegających, o składowych typu cholesterolu, o typu tłuszczy, czynnikach prowadzących do stanu śródbłonka itd. Sam określił ten stosunek jednego do drugiego jako lepszy marker od standardowych, a nie jako panaceum na wyniki i idealną metodykę pomiarów... Baa, w trakcie tych 3 lat filmów są lepsze i ważniejsze rzeczy do śledzenia / pilnowania. O innych czynnikach ryzyka Bartosz mówi cały czas, przecież o tym są jego filmy, co realnie wpływa na zły stan i podatności... A tamten wymienia takie płytkie chochoły, jakby sugerując, że Bartosz o nich nie wspomniał. Ilość informacji jest żałosna i najlepsze, że nie podaje bezpośrednio słów do których odnosi się... A najwidoczniej odnosi się do chyba tylko jednego filmu sprzed 4 lat... Najlepsze, że podaje tylko autora książki do kłócenia się z nią, bo to przecież tylko opinia... Tak, ale Bartosz zawsze linkuje badania i przez lata masz całe mnóstwo. Nie zająknął się o badaniach wspomnianych przez Bartosza, tylko sam wymyśla argumentację z którą walczy. Dużo większy zakres wiedzy i porównaj język, natężenie informacji, badania...: -
Polityka w Polsce i na Świecie - wątek ogólny
musichunter1x odpowiedział(a) na Spl97 temat w Dyskusje na tematy różne
Chyba ty nie oglądałeś uważnie, wspomnieli odnośnie modów i społeczności, a nie samych gier... Np. Roblox bywa użyty m.in. do kontaktowania się z dziećmi przez pdf. To zupełnie nie był ten typ przekazu... Po prostu skojarzyło Ci się ze starymi nagongami i wrzuciłeś sytuację do jednego worka z napisem "demonizowanie gier". Telewizja na pewno coś tam źle ujęła, ale serio przesadnie się tym nakręcasz. -
Polityka w Polsce i na Świecie - wątek ogólny
musichunter1x odpowiedział(a) na Spl97 temat w Dyskusje na tematy różne
Gordon, jakbyś chciał żebym Ciebie znowu całego przeczytał to było nie kpić, teraz tylko prześwietliłem twój komentarz i nigdy więcej nie rozwinę. Straciłeś szansę na dalsze dyskutowanie ze mną i jak chcesz coś dodać to użyj proxy, bo moje postanowienie do końca roku to nigdy nie otworzyć od ciebie komentarza. A umiesz czytać co napisałem? Znam temat i te pytania służyły sprawdzeniu tego jak jesteś zorientowany. Na tą stronę trafiłem już dawno temu, jak sam sprawdzałem temat i wagę zarzutów, bo w przeciwieństwie do Ciebie często sprawdzam argumentację obydwu stron i wyrabiam swoją opinię. Nie mam zamiaru znowu pocić się dla Ciebie, bo i tak nie traktujesz dyskusji poważnie i całkowicie zakładasz, że jeśli coś jest w postaci filmu na youtube to musi być złe. Będę coś argumentował, rozpiszę się, a podsumujesz to jako "bzdury". Znam to zabawę obliczoną na marnowanie mojego czasu. Poza tym prawo wielokrotnie udowadnia, że coś może być z nim zgodne, ale to nie znaczy że jest logiczne, dlatego pytałem również na czym jest to oparte. Niestety marnujesz swoją szanse na przedstawienie czegoś merytorycznego swoimi słowami, ignorując moje. Żegnam Kto chce może zapoznać się z argumentami. Polecam przejrzeć Bartosza Czekała i można powiedzieć, że nie jest to offtop... W końcu odwrócono piramidę żywieniową, a ustanowienie poprzedniej oparte jest na przekrętach. Jego filmy nadbudowują wiedzę stopniowo i trwa to już lata, więc stąd pewne rzeczy są już "oczywiste" w nowszych.

